


这台 Mac 上有记忆与规则文件、几十个代码仓库、二十多个定时任务、站点源码、路由器配置和各类 API token。开发者会面临两个风险:
- 如果 Claude Code、Codex 这类订阅制 AI 账户被封,工作还能接上多少?
- 如果这台 Mac 坏了或丢了,还能找回多少?
前提是 Apple ID、iCloud、邮箱和手机号都还在。
第一个问题答案很短:记忆和规则都是本地纯文本,Claude 与 Codex 两套配置早已并行维护,换一个 AI 当天就能接着干。本文讨论的是第二个问题。
本文速览 · 摘要 · 定义 · FAQ
TL;DR
- 审计结果:71 个仓库中 32 个没有远端,145 个提交未推送,Time Machine 未配置,环境配置和凭据没有任何异地副本。
- 备份范围按信息密度划定:代码、规则、算法、压缩过的知识库上云;视频成片、AI 会话原始记录、可重新下载的行情数据只留本地。
- 实现是一条每天 13:00–14:00 跑完的 launchd 备份链,不加常驻进程。新增两个任务:
git-sweep(每日扫描全部仓库,只推不提交)和secrets-vault(每周把凭据打成 age 加密包传到私有仓库的 Release)。 - 所有自动推送共用一个闸门库:push URL 白名单、现查远端、逐提交扫路径、扫对象体积、推送固定 OID,任何一步无法判定就当失败(fail-closed)。
- 代码由 Claude Code 编写,由 OpenAI Codex 只读审查五轮,阻断级问题 10 → 5 → 1 → 1 → 0。
- 恢复演练:下载加密包、校验 SHA-256、解密清点 745 个条目全部一致,错误密钥无法解开。高密度资产估计约 90% 可自动复原。
Definition
按信息密度备份:判断一份数据是否进入异地备份,只看一个问题——丢了之后能不能重新生成(重新下载、重新渲染、重新跑一遍)。不能重新生成的高密度内容(代码、规则、方法论、作品)每天上云;能重新生成的大容量数据只留本地。它和「全盘镜像」是两种取舍:前者用很小的存储和带宽保住不可再生的部分,后者保住一切但成本和泄露面都更大。
FAQ
为什么不直接开 Time Machine?
Time Machine 解决的是「同一地点的硬件故障」,Mac 丢失或连同移动硬盘一起损毁时帮不上忙。它可以作为补充,但不能替代异地备份。本方案落地时 Time Machine 仍未配置,见「已知局限」。
凭据为什么不直接放进私有 git 仓库?
私有仓库的访问控制取决于 GitHub 账户和所有拥有访问权的 token。明文凭据一旦进入 git 历史,就很难彻底清除。加密后再上传,泄露 GitHub 侧只会泄露密文。
为什么要让另一家的模型来审查?
同一个模型审查自己写的代码,容易带着同样的假设。换一家模型、只给只读权限,更容易发现作者自测时没想到的边界情况。本次第一轮就判定「不通过」,列出 17 条问题。
这套方案适合多人团队吗?
不直接适合。它的威胁模型是「单人 Mac,防疏忽导致明文上云、防备份静默失败」,不防已经控制本机的攻击者,也没有处理多人权限。闸门和加密包的思路可以迁移,具体脚本需要重新设计。
References and Further Reading
- Filippo Valsorda,age 文件加密工具与格式规范,github.com/FiloSottile/age、age-encryption.org/v1。
- Betsy Beyer 等,Site Reliability Engineering,O'Reilly,2016,第 26 章 Data Integrity(备份的价值在于能恢复)。
- US-CERT,Data Backup Options,2012(3-2-1 备份原则)。
- Git 文档:
git-log(-m、--root、-z)、git-ls-remote、git-rev-list --objects、git-cat-file --batch-check。 flock(2)手册页。
01 · 现状审计
审计的原则是实测,不信记忆。记忆文件里写着「每天自动备份到 GitHub」,这只能说明有备份,说明不了备份覆盖了多少。所以需要逐项扫描:每个仓库有没有远端、有多少提交没推、Time Machine 状态、iCloud 同步范围、每个备份脚本实际做了什么。
| 项目 | 结果 |
|---|---|
| 没有远端的仓库 | 71 个中 32 个,包括备份脚本自身所在的仓库 |
| 已提交未推送 | 145 个提交,其中一个核心算法仓库积压 3 个月 |
| Time Machine | 未配置 |
| 环境配置(SSH 主机表、自建脚本、定时任务、软件清单) | 无异地副本 |
| 凭据(SSH 私钥、API token、路由器配置) | 无异地副本 |
按资产性质可以把这台 Mac 分成四层:
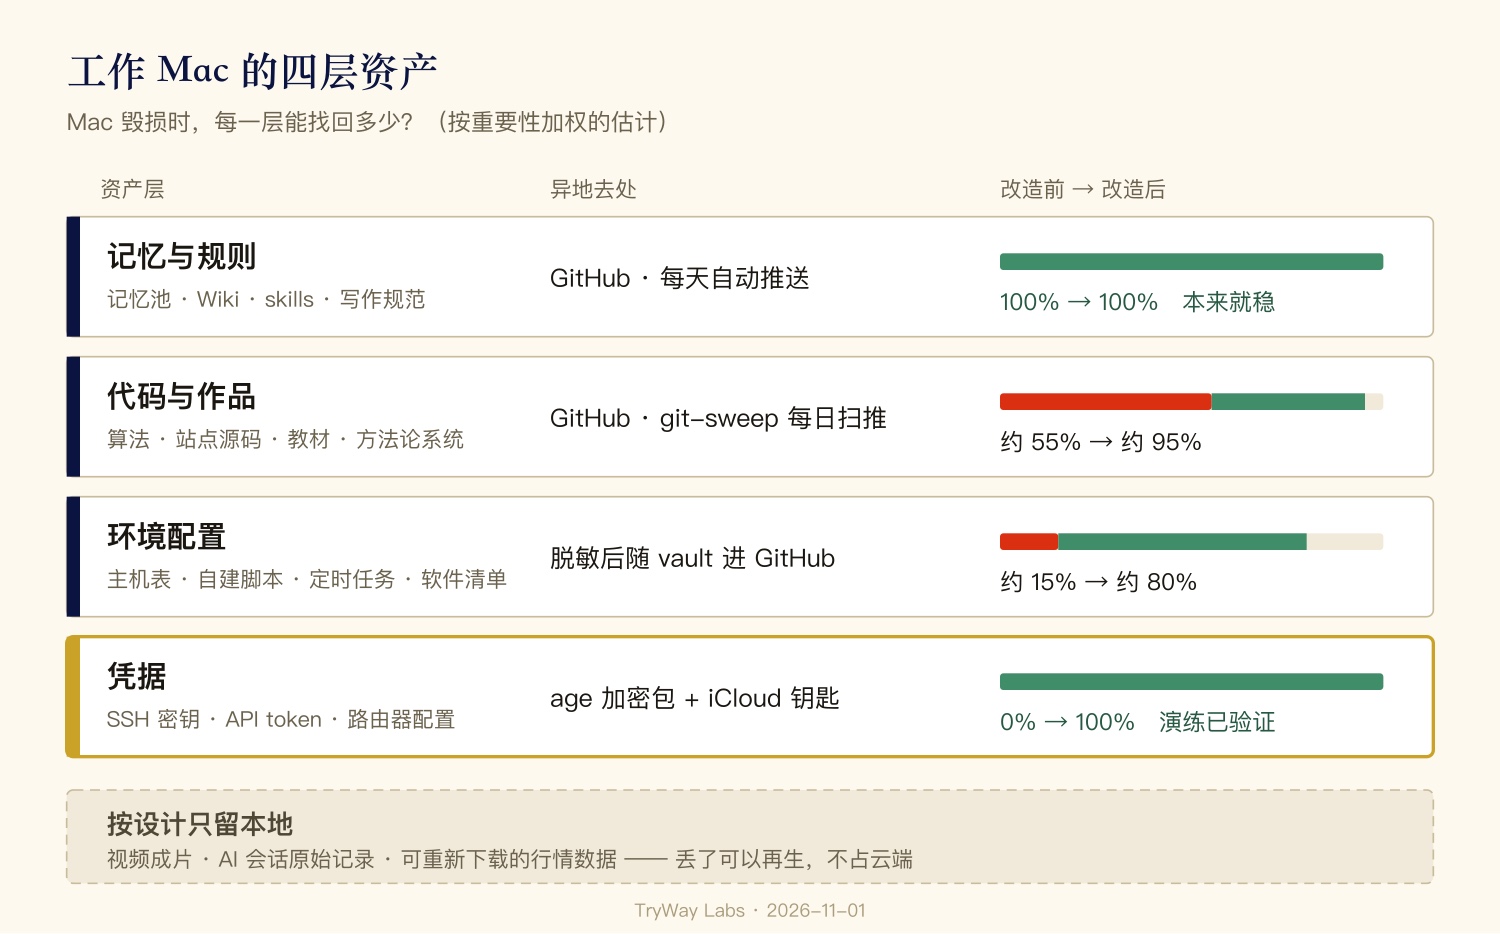
记忆与规则层本来就有每日推送;问题集中在代码、环境和凭据三层。
审计报告本身也出过错:初版写「磁盘使用率 13%」,复查发现那是 APFS 只读系统卷的数字,数据卷实际已用 80%。此后报告里的每个数字都要求能对应到一条命令输出。
02 · 备份范围:按信息密度划分
初版建议是把 AI 会话原始记录和视频项目的积压提交都推上云。复核后改为按信息密度划分:
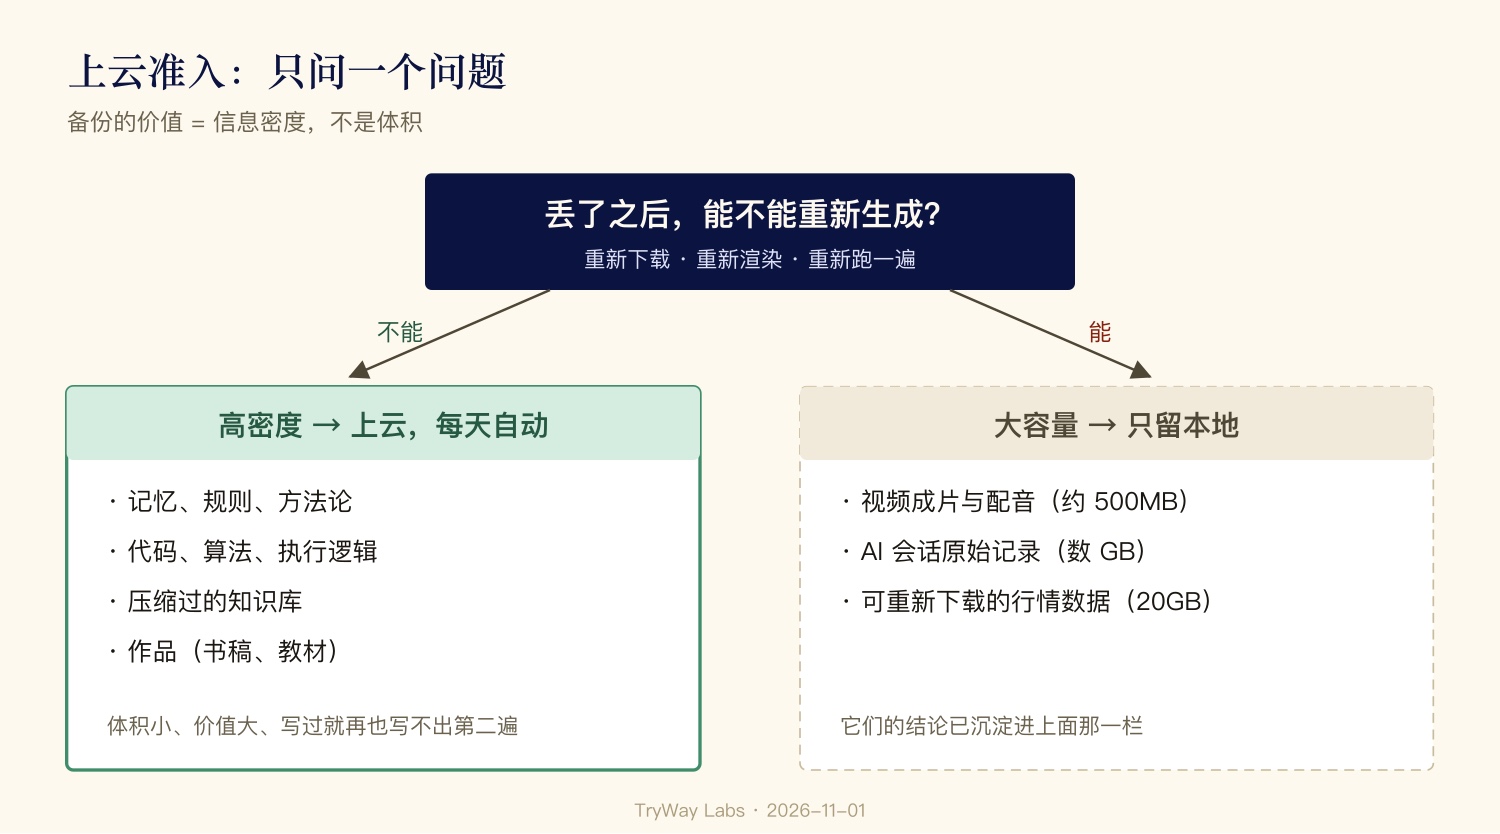
按这条规则重新计算:
- AI 会话原始记录按设计只留本地,不再算缺口;从中提炼出的知识库每天推送。
- 视频项目的 58 个积压提交里混有 969 个音视频和图片文件,约 496MB。剥离媒体后,需要推送的代码只有 6.9MB。
- 知识库仓库在 GitHub 上占 470MB,大部分是三个月前一次历史瘦身时留下的备份分支,原计划观察一周后删除,一直没删。
这一步决定了后面所有脚本的边界。如果先写工具再定范围,自动化会把不该上云的东西也忠实地推上去。
03 · 架构:一小时内跑完的备份链
设计约束只有两条:不增加常驻进程;尽量挂在已有的备份时间窗口上。
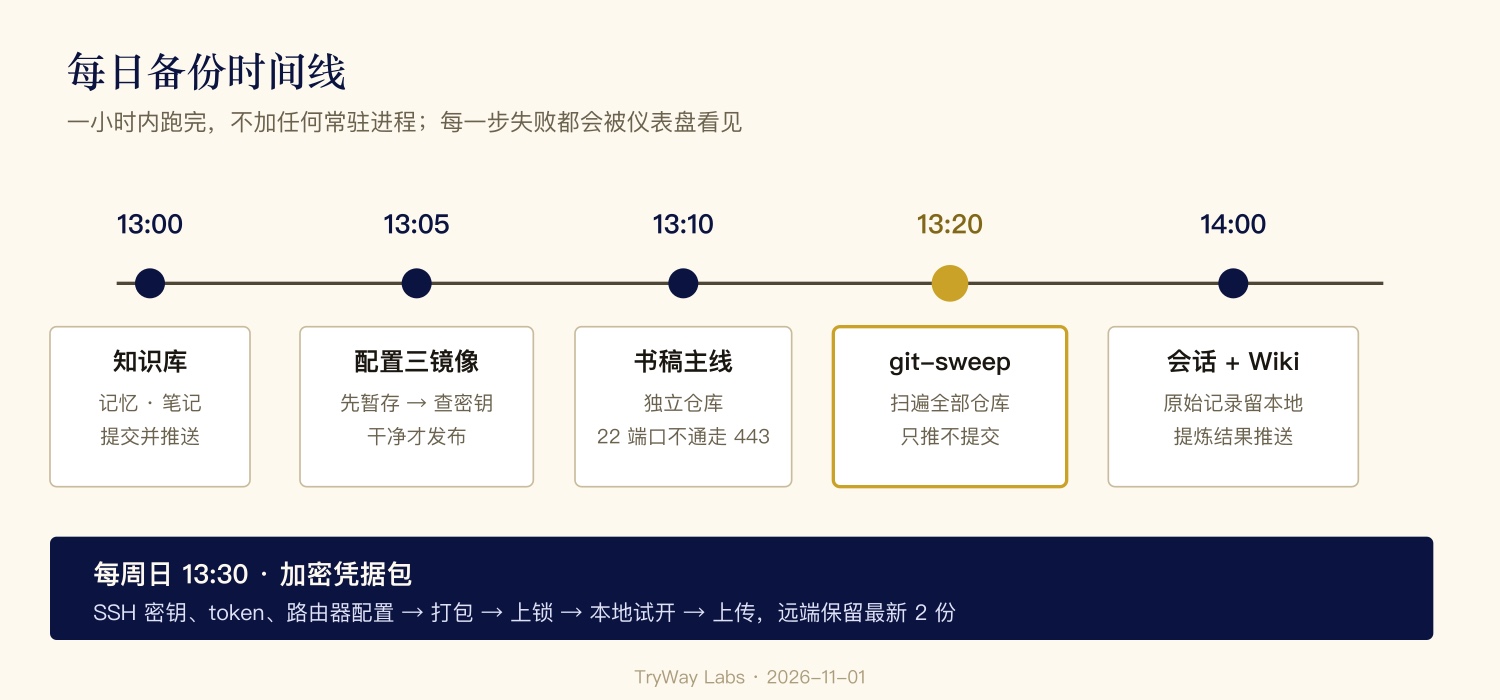
| 时间 | 任务 | 说明 |
|---|---|---|
| 13:00 | 知识库 | 已有任务,提交并推送笔记与记忆 |
| 13:05 | 配置镜像 | 改造:先在私有暂存目录生成三份镜像并检测密钥,通过后再写入知识库(次日 13:00 随之上云) |
| 13:10 | 书稿仓库 | 已有任务,22 端口不通时改走 443 |
| 13:20 | git-sweep | 新增:扫描全部仓库,推送已提交未推送的分支 |
| 14:00 | 会话与 Wiki | 已有任务,原始记录留本地,提炼结果推送 |
| 周日 13:30 | secrets-vault | 新增:凭据加密包 |
每个任务都由 launchd 调度,外面套一层等待网络就绪的包装脚本,退出码非 0 时在本地仪表盘告警。
git-sweep 的规则是只推不提交:什么时候提交仍由开发者和各项目自己的规则决定,脚本只负责不让已经提交的内容长期留在本地。它只推远端已存在的同名分支;新分支首次推送需要手动 push -u,脚本记日志但不代劳。
为了上线,开发者另外新建了 8 个私有仓库,并把 15 个仓库的积压提交一次推平。批量推送前先查了一遍 Cloudflare,确认没有站点配置了「推送即自动部署」,否则积压的几十个未发布提交会直接上线。
04 · 推送闸门
自动推送最大的风险是推错东西。所以知识库、书稿、会话、配置、git-sweep 这几个推送入口都 source 同一个闸门库 lib-backup.sh,不允许各自实现。
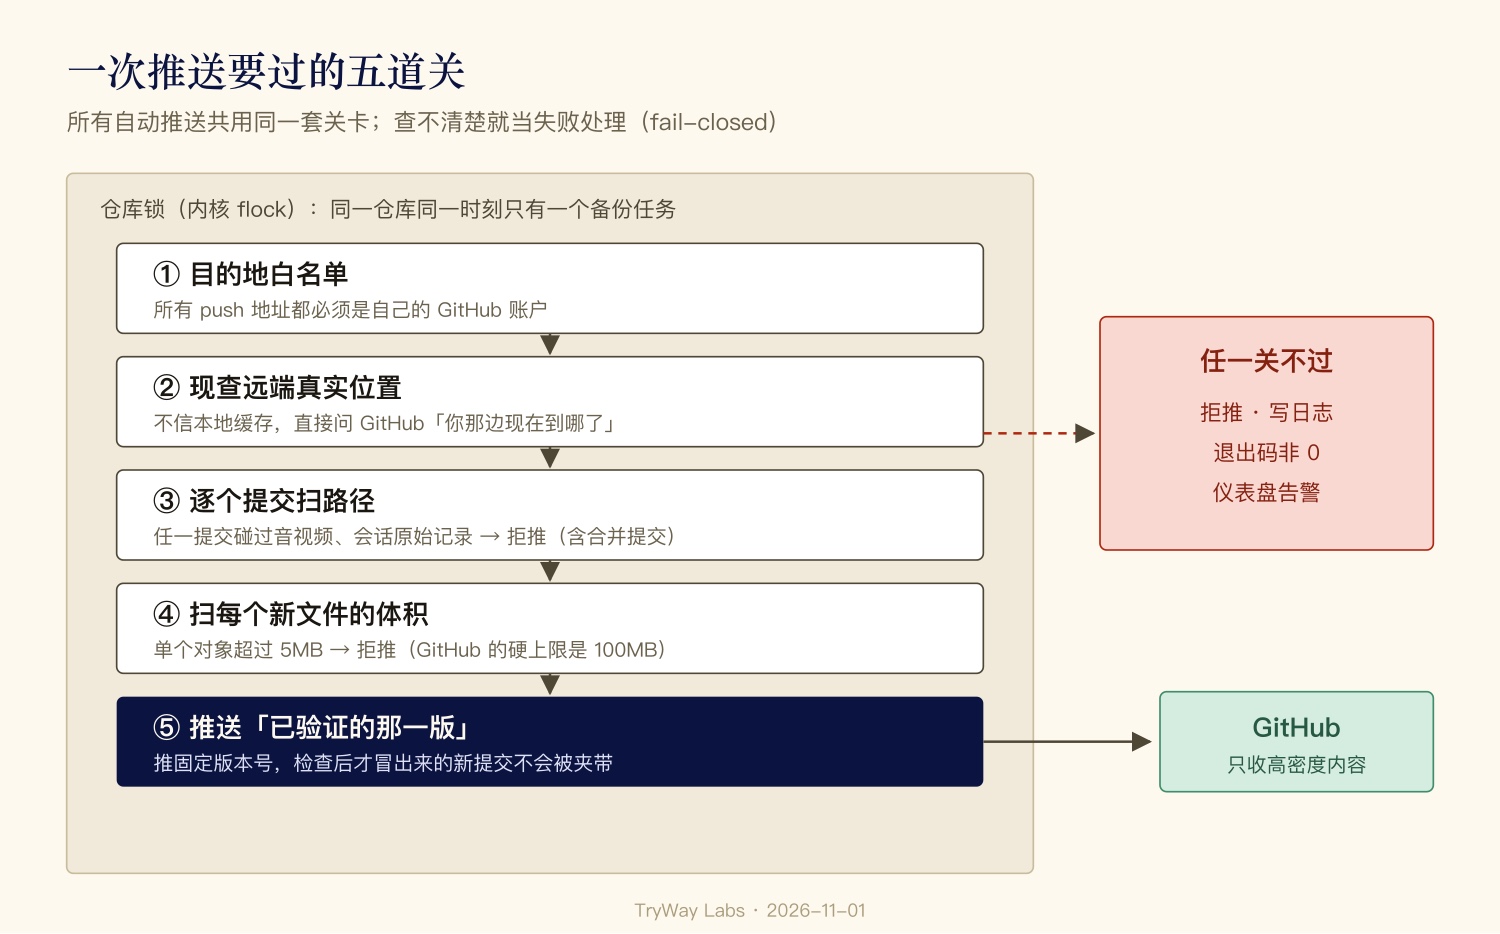
外层是仓库级互斥锁。锁用内核 flock,挂在 shell 持有的文件描述符上,进程退出时自动释放,不会留下陈旧锁。macOS 没有 flock(1) 命令,这里借用系统自带的 Perl:
exec 8>>"$gitdir/1984-backup.lock"
/usr/bin/perl -e '
  use Fcntl ":flock";
  open(my $fh, ">&=", $ARGV[0]) or exit 2;
  for (1 .. $ARGV[1]) { exit 0 if flock($fh, LOCK_EX | LOCK_NB); sleep 1 }
  exit 1;
' 8 300
锁内依次过五道检查:
- push URL 白名单。
git remote get-url --push --all origin返回的每一个地址都必须属于自己的 GitHub 账户,第三方上游一律跳过。 - 现查远端。用
git ls-remote对每个实际 push URL 查分支 tip,不信本地的origin/*缓存,也不用 fetch URL 代替 push URL。远端有本地没有的提交、或已分叉,就跳过并记日志。 - 逐提交扫路径。只看最终 diff 会漏掉「中间某次提交加入、之后又删除」的大文件。这里用
git log -z -m --root --no-renames --name-only列出待推范围内每个提交触及的路径,合并提交对每个父提交分别展开,根提交也包含在内。音视频扩展名、会话原始记录目录命中即拒推。 - 扫对象体积。
git rev-list --objects列出待推对象,再用--not git cat-file --batch-check取体积,任何 blob 超过 5MB 即拒推(GitHub 的硬上限是 100MB)。 - 推送固定 OID。检查的是某个提交 ID,推送的也是这个 ID:
git push。检查之后才出现的新提交不会被一起带上去。:refs/heads/
闸门函数的返回码有三种:0 通过,1 策略拒推,2 无法判定。2 按失败处理。
fail-closed 是这套设计里最重要的约定。 备份系统最危险的状态不是失败,而是失败了却报告成功。dry-run 时就遇到过一次:脚本里 $branch 后面紧跟一个全角括号,macOS 自带的 bash 3.2 把它当成变量名的一部分,set -u 判定变量未定义,子 shell 退出,整个扫描根被跳过,而汇总行依然报告一切正常。修复分两层:变量一律写成 ${branch};每个扫描根跑完必须输出一行 root_done,汇总时核对数量,少一个就计为失败。
05 · 凭据:age 加密包
SSH 私钥、API token、路由器配置不能以明文进 git,但 Mac 丢失后又必须能找回。这里用 age 做非对称加密。
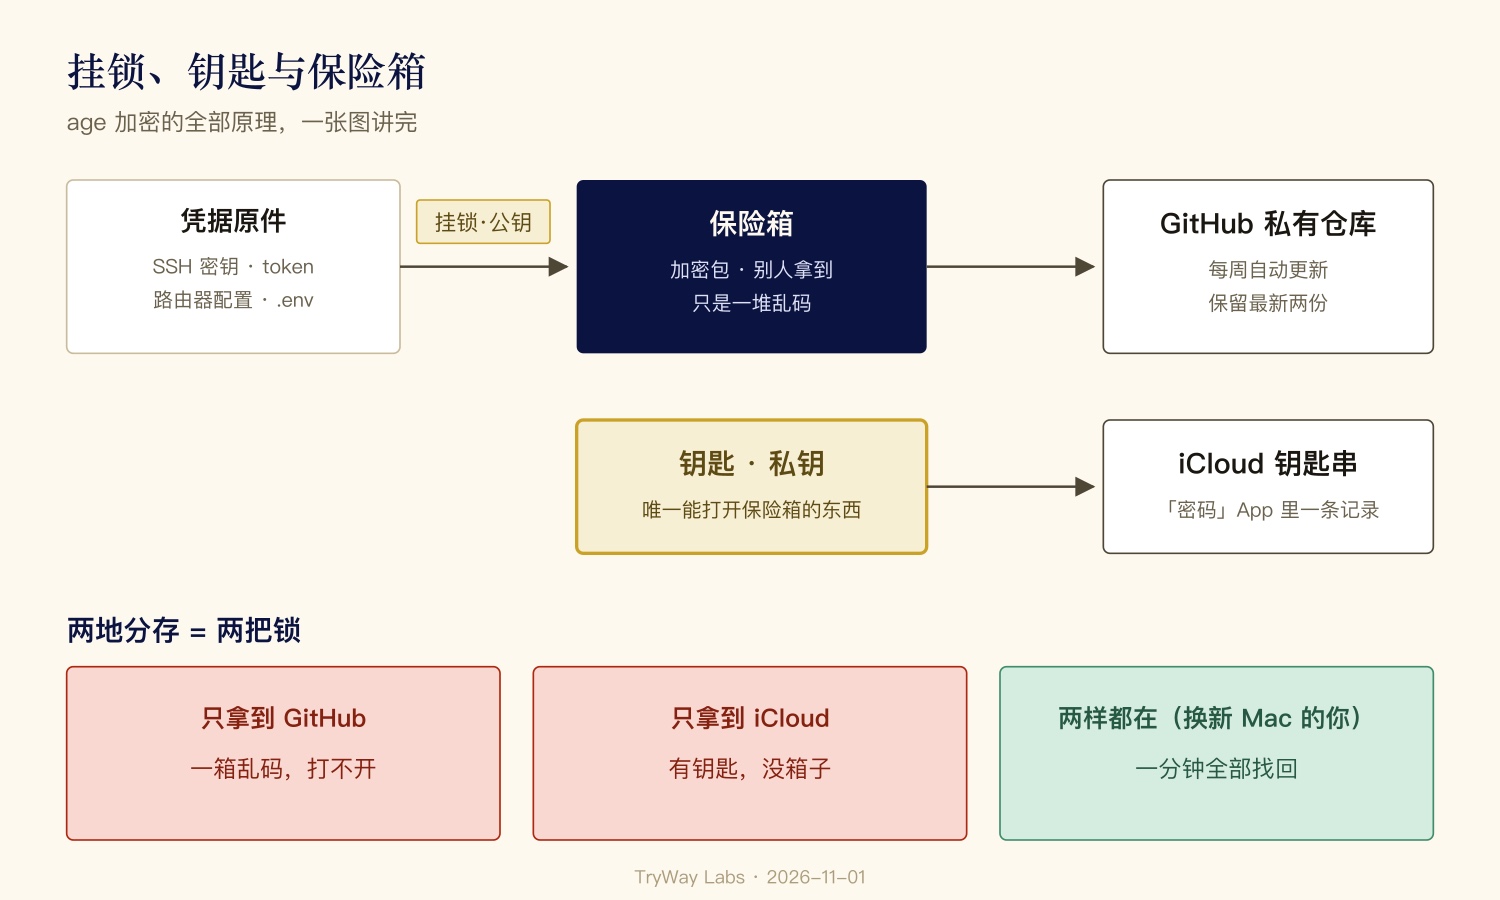
- 公钥只能加密。每周的定时任务只用公钥,不需要交互输入口令。
- 私钥存进 iCloud 钥匙串(「密码」App 中的一条记录)。存入后从 App 复制出来重新推导公钥,与本机公钥一致,确认存储无误。本机也保留一份权限为 600 的私钥,用于下面的往返校验。
- 加密包上传到 GitHub 私有仓库的 Release,文件名带时间戳,远端只保留最新两份。
只拿到 GitHub 侧只有密文;只拿到 iCloud 侧只有密钥没有数据。两边同时可用,正好对应「Apple ID 和邮箱还在」这个前提。
secrets-vault.sh 的流程:
tar -czf - --no-xattrs --no-mac-metadata -T "$LIST" | age -R "$PUB" -o "$OUT"
# 本地往返校验:能解密、能列目录、条目数 > 0;没有私钥就无法证明可恢复 → 失败
age -d -i "$KEY" "$OUT" | tar -tzf - | wc -l
gh release upload "$TAG" "$OUT" "$OUT.sha256"
# 远端体积与本地一致之后,才删除除最新两份以外的旧资产
几个细节:
- 私钥本身不进包,否则就是把钥匙锁在箱子里。打包清单是显式列出的路径,不用通配,避免把
~/.config/age/顺手带进去。 - 新版先上传、核对远端体积,再删旧版,任何时刻远端至少有一份完整副本。
- 空仓库不能创建 Release(GitHub 返回 HTTP 422),首次运行先写一个只含说明的 README。
set -e中途退出时由ERRtrap 写日志,避免「脚本退了但日志里什么都没有」。
06 · 配置镜像的密钥检测
环境配置(SSH 主机表、~/.local/bin 下的脚本、LaunchAgent plist、Claude Code 设置、Brewfile、pipx 清单)需要以明文进入知识库,这样新机器上读一遍就能重建环境。难点是其中可能夹着密钥。
最终结构是:
- 三份镜像全部先在知识库之外的私有暂存目录(权限 700)中组装。
- 结构化导出:
settings.json用jq按字段白名单导出;plist 用plutil改值,EnvironmentVariables中敏感键的值改为REDACTED,结果仍是合法 XML。 - 能以自由格式藏密钥的文件(shell 启动文件、Codex 配置、
secrets.env)不进入明文层,原件只进加密包。 - 对暂存目录逐文件检测:已知 token 前缀、PEM 私钥头、长 base64 行、敏感键赋值、命令行口令参数、plist 参数对、TOML 多行字符串。JSON 文件先用
jq -r '.. | strings'把字符串值解码成纯文本再检测,否则\"转义会让正则失效。 - 任一文件可疑,整批不发布,知识库保留上一版;检测日志只记录文件相对路径和命中类型,不打印内容。
第 3 步是第二轮审查之后才加的,详见下一节。
07 · 独立审查:五轮记录
代码写完后,开发者用 Codex(只读沙箱)通读全部备份脚本做验收。审查提示从第 4 轮起写明了威胁模型:单人 Mac 的个人备份,防的是疏忽导致明文上云和备份静默失败,不防已经控制本机的攻击者。没有这条边界,审查会无限加码。
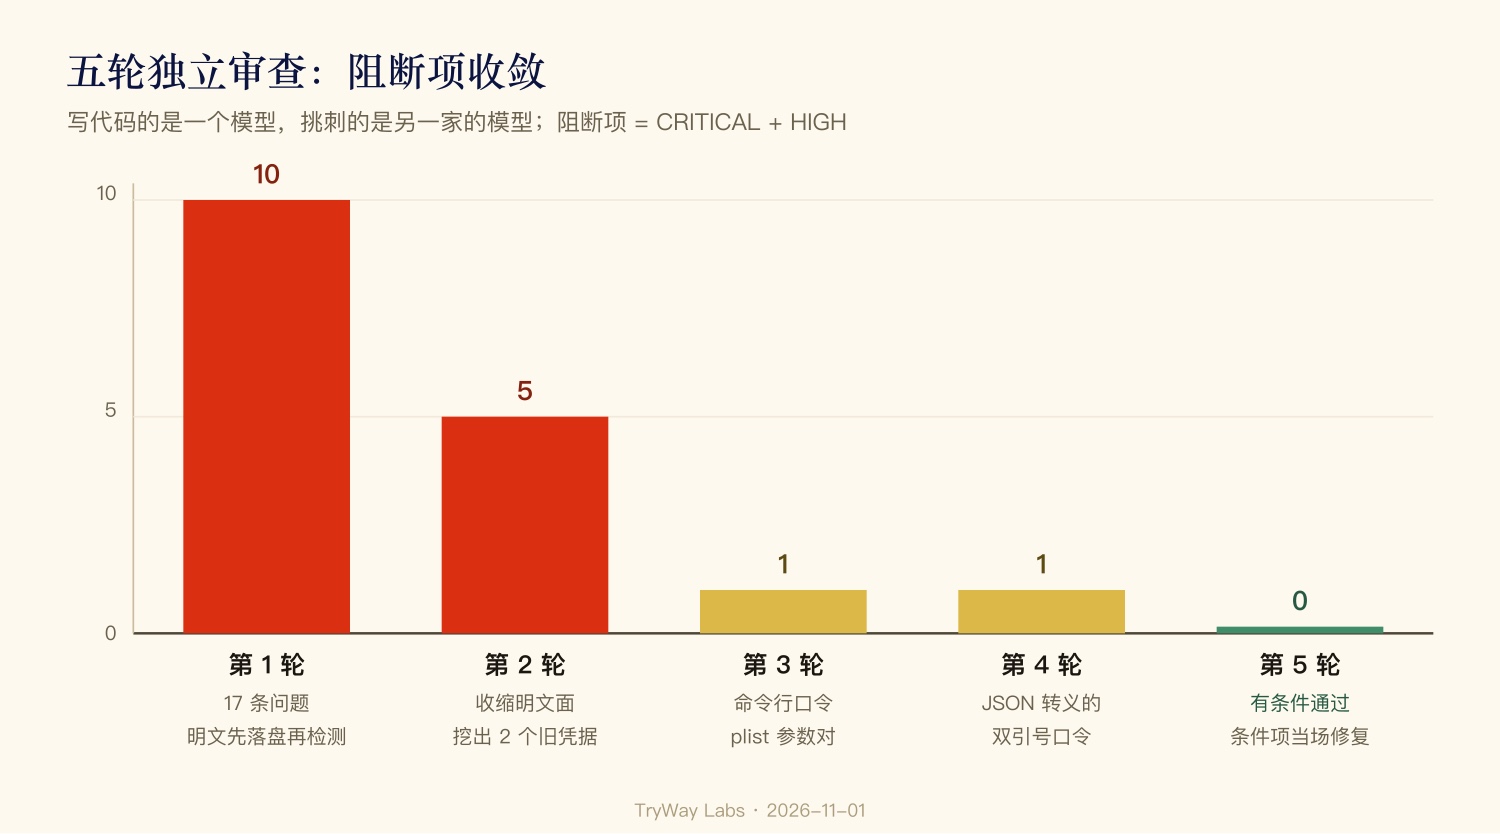
| 轮次 | 主要问题 | 修复 |
|---|---|---|
| 1 | 17 条,其中 CRITICAL 2、HIGH 8。最严重的是配置镜像「先写入知识库、再检测密钥」,检测发现问题时明文已在每日推送的目录里;mkdir 锁可能残留;部分推送入口绕过闸门 | 改为暂存区检测、通过后再发布;抽出共享闸门库,所有入口接入;推送固定 OID |
| 2 | 正则脱敏总能被构造出新的绕过;本地缓存的远端位置不可信;合并提交未展开 | 不再追加正则,改为让自由格式配置不进明文层;锁换成 flock;ls-remote 现查;log -m --root |
| 3 | 命令行 --password 值 形式漏检;带引号的路径可绕过禁推规则;上一轮新增的参数校验与实际用法不符 | 补命令行参数、plist 参数对、TOML 多行字符串;路径改用 log -z 按 NUL 分隔匹配;修复回归 |
| 4 | JSON 中转义为 \"值\" 的口令漏检;ls-remote 查的是 fetch URL 而非 push URL | JSON 先解码再检测;按实际 push URL 查询,不在白名单计为拒推 |
| 5 | 有条件通过:配置多个 push URL 时「本地落后」判断会提前短路 | 当场修复并模拟验证 |
三点体会:
- 第 2 轮的方向调整比任何单条修复都重要。 基于正则的密钥检测不可能完备,与其继续加规则,不如缩小需要检测的范围。
- 审查需要威胁模型。 写明防什么、不防什么,审查意见才会收敛。
- 修复会引入新问题。 第 2 轮加的参数校验在第 3 轮被发现与实际调用不符。每轮修复后都要全量重测,不能只测改动点。
08 · 过程中的失误
扫描时泄露了凭据。 扫描配置文件中的密钥时,命令把匹配行输出到终端,指望后面接的 sed 打码。但 macOS 的 BSD sed 不支持 \s,正则静默失效,4 个 token 以明文进入会话记录,只能逐一轮换。规则改为:扫描密钥只输出计数和文件名,任何情况下都不打印匹配内容。
备份文件差点放错位置。 迁移一个硬编码的 key 时,原文件备份放在了原目录,而那个目录每天镜像上云。及时发现并移走。
新检测器发现了旧问题。 改造后的检测器第一次在真实数据上运行,就拦下了两个半年前硬编码在 AI 指令文件里的凭据。随后对知识库的全部 git 历史做了一次扫描,又找到几个已删除但仍留在历史中的旧凭据。处理方式:当前文件中的迁入本地 secrets.env,原处改为引用环境变量;只在历史中的通过轮换使其失效,不改写历史(需要强推,不可逆,且无法控制 GitHub 侧缓存)。
不可逆和外传操作由人执行。 过程中 Claude Code 的安全分类器拦下了两次操作:删除远端分支(不可逆)和上传加密凭据包(数据外传)。两次都改由开发者手动执行。这个分工是对的。
09 · 恢复演练
备份能恢复才有意义。最后一步是模拟换机:从 GitHub 下载加密包,核对校验和,解密并清点内容。
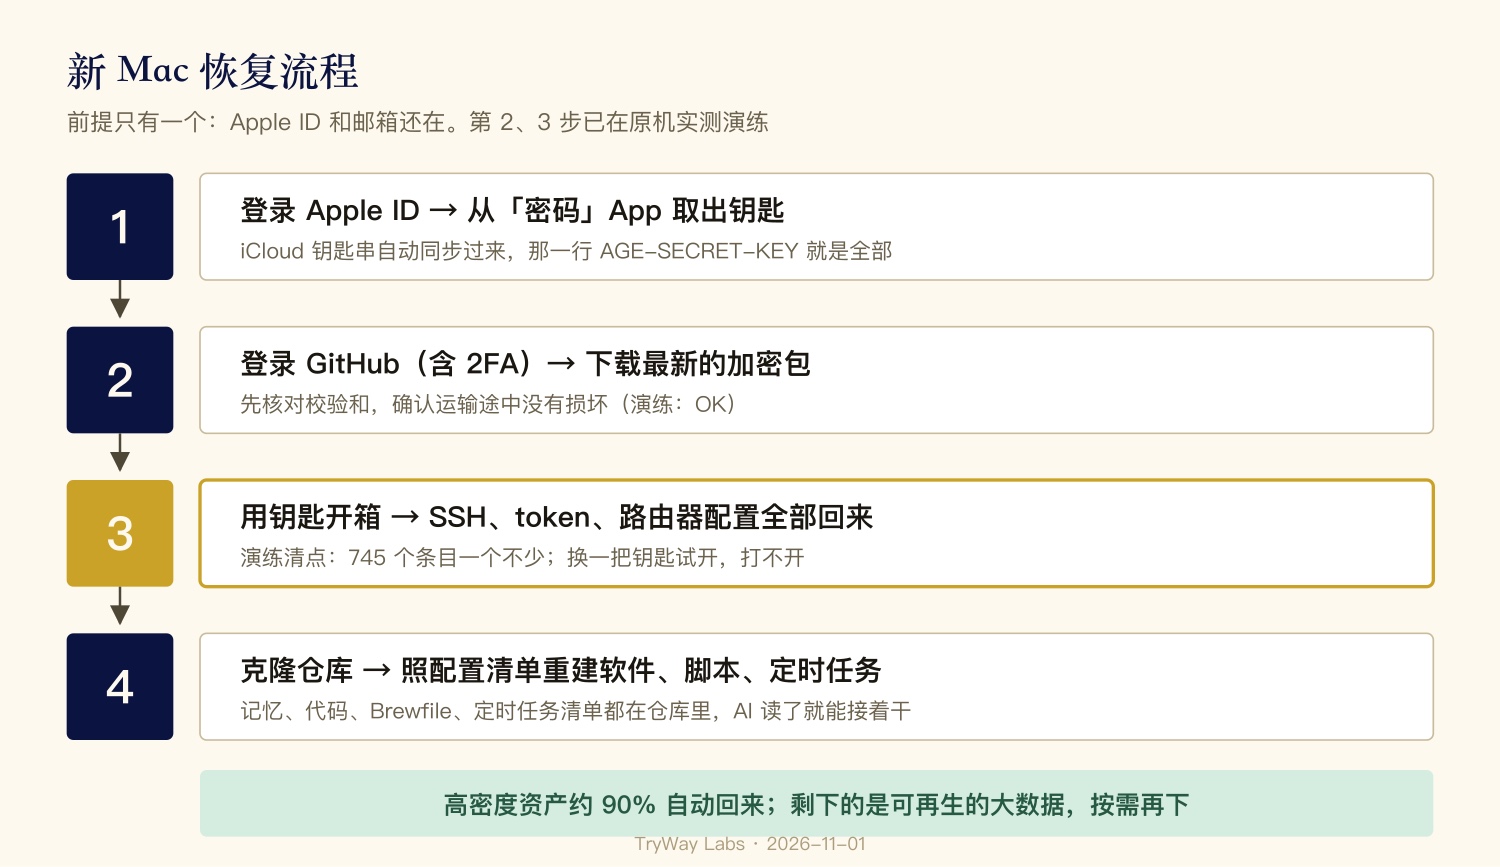
gh release download vault-latest -R <owner>/<vault-repo> -p 'secrets-vault-*'
shasum -a 256 -c secrets-vault-<stamp>.tar.gz.age.sha256
age -d -i vault.key secrets-vault-<stamp>.tar.gz.age | tar -tzf - | wc -l
结果:
- 校验和一致;解密后 745 个条目,与上传时的本地往返校验一致。
- SSH 密钥、主机配置、各类 token、路由器配置(718 个文件)、各项目
.env均在包内。 - 用随机生成的另一把 age 密钥解密,失败。
- 演练只列目录,不把解密内容写入磁盘。
实际耗时不到一分钟。中间一次卡顿是演练里一条列文件的命令在后台挂起,与备份系统无关。
10 · 已知局限
| 局限 | 影响 | 计划 |
|---|---|---|
演练在原机完成,复用了已登录的 gh;「新机安装 age、登录 GitHub、按清单重建环境」没有在干净机器上走过 | 第 4 步的耗时和缺口未知 | 下次换机或用虚拟机补一次完整演练 |
| 新机下载私有 Release 需要登录 GitHub;如果 2FA 因子只存在于这台 Mac,恢复链会断 | 可能卡在第 2 步 | 确认 2FA 恢复码与另一设备上的验证器 |
| 凭据包每周一次 | 轮换 token 后最长 7 天包内是旧值 | 轮换属于人工操作,流程里加一步:轮换完成后手动运行一次 secrets-vault.sh。不加文件监听触发,避免误触发和额外告警 |
git-sweep 的「跳过」(新分支、本地落后、已分叉)只写日志,不影响退出码 | 长期跳过的仓库不会告警 | 仪表盘显示跳过数,持续多日即告警 |
| 规则与 skill 文档只做 token 形态检测,不做「键=值」检测(避免误伤文档示例) | 非标准前缀的 token 写进文档可能漏检 | 已知取舍;依靠「扫描只出计数」与定期全历史扫描兜底 |
| 配置镜像 13:05 生成,知识库 13:00 推送 | 配置变更约 24 小时后才上云 | 可接受;如需缩短,改为在 13:05 后补一次推送 |
| Time Machine 仍未配置 | 本地硬件故障时,大容量可再生数据需重新下载 | 补一块本地备份盘 |
另外,「约 90% 可自动复原」是按重要性加权的估计,不是测量值。
11 · 可复用的做法
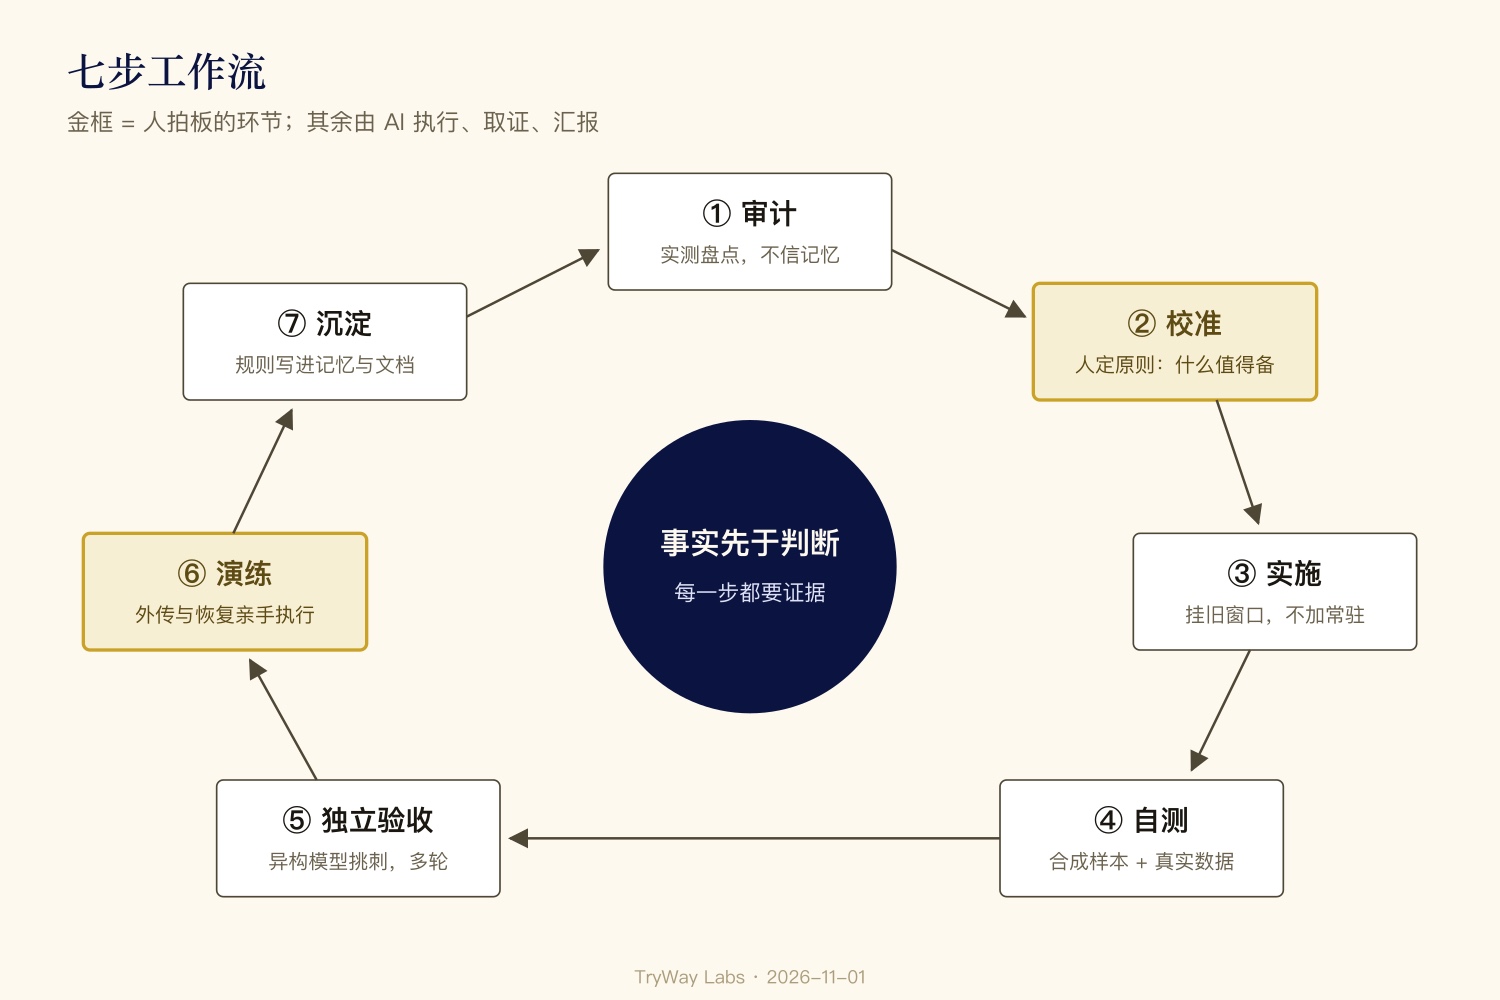
- 先实测再判断。 记忆里的「每天备份」不等于覆盖完整;32 个无远端仓库是扫出来的,不是想出来的。
- 先定范围再写工具。 一条信息密度规则砍掉了约 496MB 的无效上云。
- 报告里的数字要能追溯到命令输出。 「磁盘 13%」就是反例。
- 挂在已有时间窗口上,不加常驻进程。
- fail-closed。 无法判定就当失败;每个扫描单元必须交回执。
- 缩小暴露面优于加强检测。 敏感文件不进明文层,比多写十条正则可靠。
- 作者和审查者用不同的模型。 只读权限,多轮,直到阻断项归零。
- 审查要有明确的威胁模型。
- 不可逆和外传操作由人执行。
- 失误写成规则。 「扫描密钥只输出计数和文件名」现在是长期规则。
整个上午,AI 执行了几百条命令、写了约 500 行备份脚本、调度另一家模型做了五轮审查。真正改变方向的决定只有几个:备份范围按信息密度划定、哪些仓库值得新建远端、哪些风险可以接受。实现和取证可以交给 AI,范围和取舍需要开发者来定。