


如何開發一個線上更新的 A 股篩選器?網路上的教學大多教到「裝個行情函式庫、寫個迴圈、把選出來的票列印出來」就收工了。可真要它每天收盤後自己更新、掛在網路上給別人看、一用好幾年,問題馬上就變了:資料來源當天沒入全怎麼辦?需求方沒說清的口徑誰來定?改了一行程式碼,線上跑的是哪一版?半夜斷網,補到一半的歷史還算不算數?
這篇就從這幾個問題出發。答案有一半在程式碼裡,另一半在程式碼之外。
本文速覽 · 摘要 · 定義 · FAQ
TL;DR
- 一位資深 A 股投資者朋友給了一張「三檔市值 × 兩種訊號 × 六個條件」的閾值表。三週後,它長成了覆蓋全部 A 股、2015 年以來十年日 K、八個模組、每個交易日一條指令自動更新的盤後監控系統。
- 前六天野蠻生長:沒有一份需求單,線上當驗收場,一天部署 9 次只提交 2 次。復盤之後立了兩樣東西:六階段 + 三檔位的工作規矩,和寫進程式裡的兩道閘門(未提交不部署、資料驟降即攔截)。
- 立規矩之後五輪,約 85 小時,217 個提交,14 次上線,自動化測試從 341 項漲到 1,090 項,線上每一版都對得上一次提交。
- 可遷移的方法論是四根柱子加一副地基:流程(先寫後做)、閘門(規矩寫進程式)、證據(對拍勝過自信)、分工(人定方向、按按鈕,agent 幹活),地基是架構克制(唯一寫入口、模組唯讀、零依賴、靜態頁)。
Definition
規矩先行的 AI 協作開發(rules-first AI-assisted development),指在大模型 agent 承擔主要編碼工作的專案裡,先把「需求怎麼記、在哪驗收、什麼時候能上線、出錯時怎麼停」寫成成文規矩,並盡量把其中的硬約束做成程式閘門,而不是寄希望於人或模型每次都自覺遵守。它和「讓 AI 寫得更快」是兩個問題:前者管的是每一次上線是否說得清是哪一版、為什麼、憑什麼,後者只管速度。
FAQ
有 AI 寫程式碼了,為什麼還要需求單、驗收、標籤這些「老一套」?
因為 AI 把寫程式碼的成本壓得極低,返工的成本卻沒降。寫得越快,沒想清楚就開工、在線上試錯、版本對不上提交的毛病就暴露得越快。規矩管的是方向和邊界,恰恰是 agent 自己管不住的那部分。
「閘門寫進程式」和「寫在文件裡要求遵守」差在哪?
文件裡的規矩靠記性,程式裡的閘門靠機制。本專案的部署指令開頭先查 git:程式、設定、說明書有未提交改動就拒絕發布,而且有意不留繞過開關。人會忘,模型會在長對話裡漂移,程式不會。
這套系統能用來炒股賺錢嗎?
不能這樣理解。它只做篩選和記錄,不做收益回測,不給買賣建議。本文講的是系統怎麼開發,不是訊號好不好。
這套方法離開 A 股還用得上嗎?
用得上。凡是「需求方說不清口徑、資料每天在變、結果要長期留檔」的系統,比如營運報表、監控面板、內部資料工具,都是同一類問題。
References and Further Reading
- Betsy Beyer 等,Site Reliability Engineering,O'Reilly,2016,第 8 章 Release Engineering(發布工程:可追溯、可重現的上線)。
- Michael Feathers,Working Effectively with Legacy Code,2004(特徵測試:改動前先把現有行為釘成基準)。
- Kent Beck,Test-Driven Development: By Example,2002(測試先行)。
- TradingView,Lightweight Charts(開源金融圖表函式庫,Apache-2.0),本專案個股 K 線圖所用。
01 · 開門見山:系統不是寫出來的,是管出來的
先說結論:一個靠 AI 寫程式碼的專案,真正的瓶頸從來不是程式碼,而是管理程式碼進入現實世界的那道門。
故事很樸素。一位做了多年 A 股的朋友,手裡有一套看盤的老經驗,凝成一張表:小、中、大三檔市值,溫和與強兩種啟動訊號,換手率、量比、振幅、收盤形態、突破位置等六個條件,每個條件一檔一檔的閾值。他的訴求也簡單:每天收盤後,幫我把符合條件的票挑出來,別讓我一隻隻翻。
三週後,這張表長成了這樣一套東西:
| 維度 | 起點(10-07) | 現在(10-21 第五輪後) |
|---|---|---|
| 覆蓋範圍 | 一個固定股票池,約 100 隻 | 全部 A 股,外加 269 個指數與板塊、寬基 ETF |
| 歷史深度 | 兩年 | 2015-01-05 起,2,864 個交易日,日 K 1,184 萬行 |
| 模組 | 啟動訊號一個 | 啟動訊號、籌碼線、指數與板塊、情緒、寬度、榜單、資金、個股 K 線圖 |
| 程式 | 5,457 行 | 12,523 行,只用 Python 標準函式庫,零第三方依賴 |
| 自動化測試 | 341 項 | 1,090 項,全部通過 |
| 每日維運 | — | 一條指令,約 5 分鐘,自動發布成靜態網站 |
寫程式碼的主力是 AI:一個主會話負責規劃、調度、驗收和歸檔,若干子 agent 分頭寫各模組和測試,另請一家不同來源的模型唯讀審查。人只做四件事:轉達需求方原話、定口徑、驗收點頭、親手按部署鍵。
這篇不講 A 股,講的是這三週裡摔過的跟頭,和跟頭摔出來的規矩。不以規矩,不能成方圓,老祖宗兩千多年前就說透了。只不過這一回,規矩不是寫給人看的,是寫給人和 AI 一起遵守的,最硬的那幾條,乾脆寫進了程式。
02 · 野蠻生長的六天:勤快救不了流程
10 月 7 日到 12 日,專案跑得飛快。啟動訊號、歷史回看、估值與公告建檔、全市場籌碼線掃描、線上網站、每日一條龍、指數與板塊狀態表,一週之內接連上線。24 個提交,每一個都帶測試。
看上去很勤快。說實在的,問題就出在這份勤快上。
12 日晚上做了一次復盤,拿後來定下的六個階段逐項對照這 24 個提交,結論扎心:
| 毛病 | 證據 | 後果 |
|---|---|---|
| 沒有一份寫在開發之前的需求單 | 11 個作品,0 份 | 當初為什麼這樣定,要翻對話、註解、文件好幾處才拼得出來 |
| 線上被當成驗收環境 | 10-11 上線後一小時連補 3 個 fix;板塊頁的寬度是在線上量的,為此多部署 4 次 | 需求方隨時可能看到半成品 |
| 線上版本對不上提交 | 10-12 部署 9 次,提交只有 2 次,全程沒有標籤 | 說不出「現在線上是哪一版」,出了事也退不回去 |
| 一個提交裝好幾件事 | 籌碼線、網站、每日一條龍三件事一個提交,20 個檔案 2,459 行 | 出問題沒法只退其中一件 |
| 文件跟在程式碼後面補 | 4 個單獨的「對齊文件」提交 | 補文件時才發現程式碼裡的坑 |
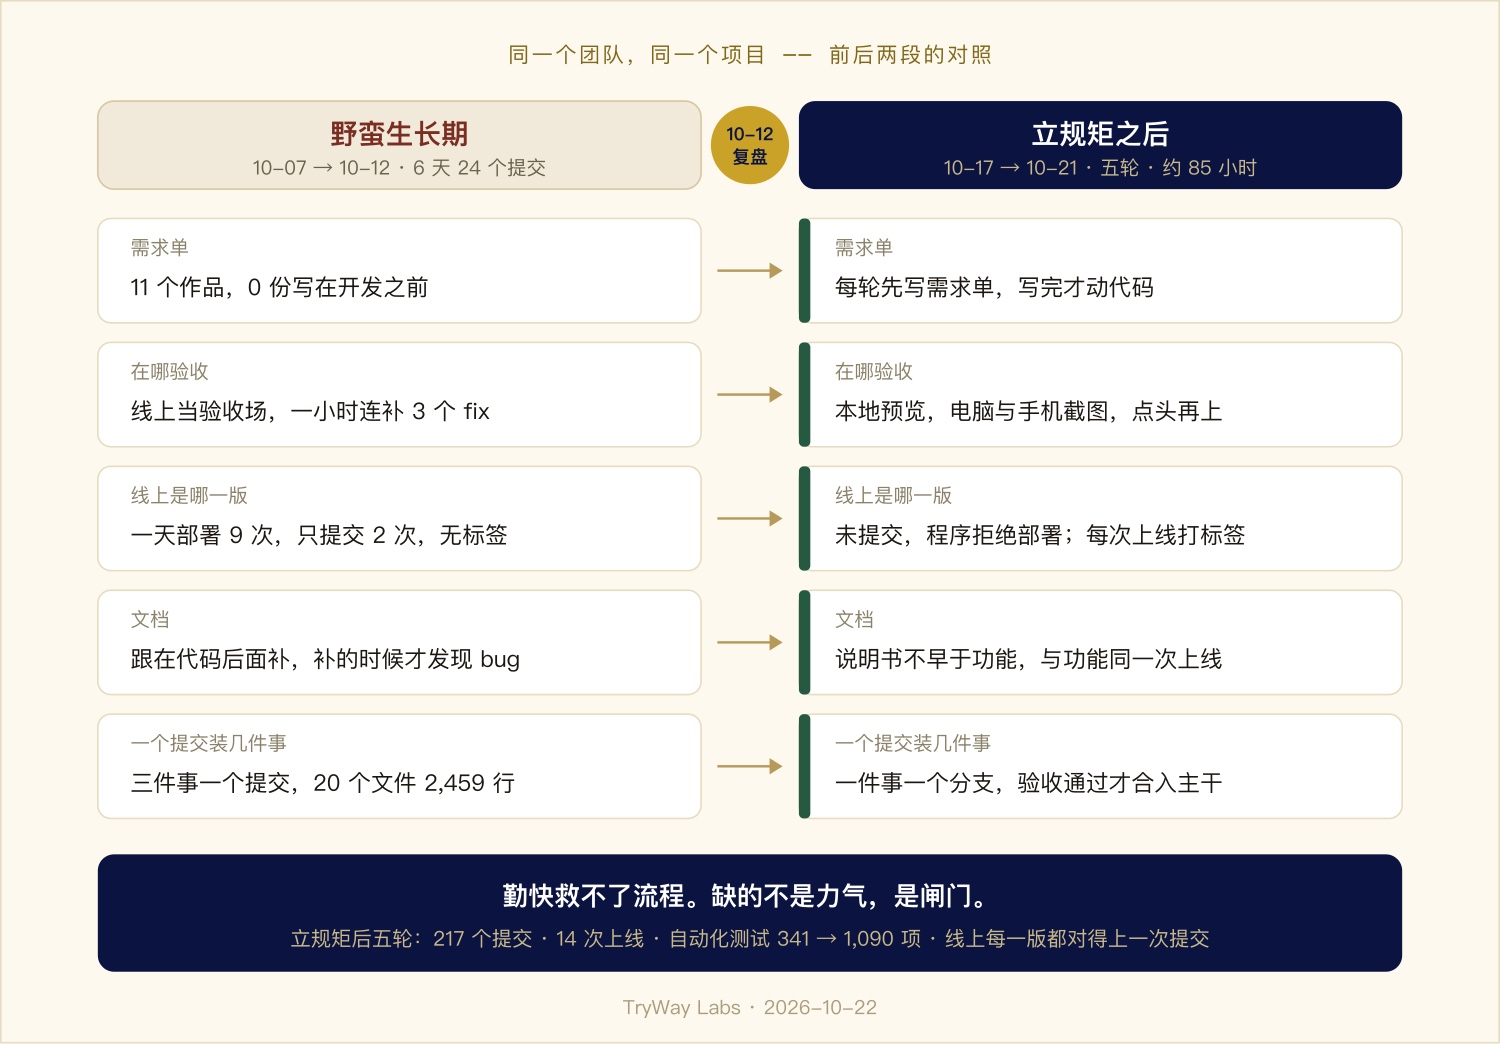
這像一支技術不差、跑動積極的球隊,沒有陣型,也沒有換人紀律。每個人都在拚,可球一丟,誰也說不清是誰的位置空了。勤快是美德,但勤快填不了流程的窟窿,只會讓窟窿漏得更快。AI 寫程式碼尤其如此:模型不累、不煩、出活極快,人一興奮,就忍不住「先上去看看效果」。千里之堤,潰於蟻穴,線上的每一次「先看看」,都是一個蟻穴。
03 · 立規矩:六個階段,各守各的邊界
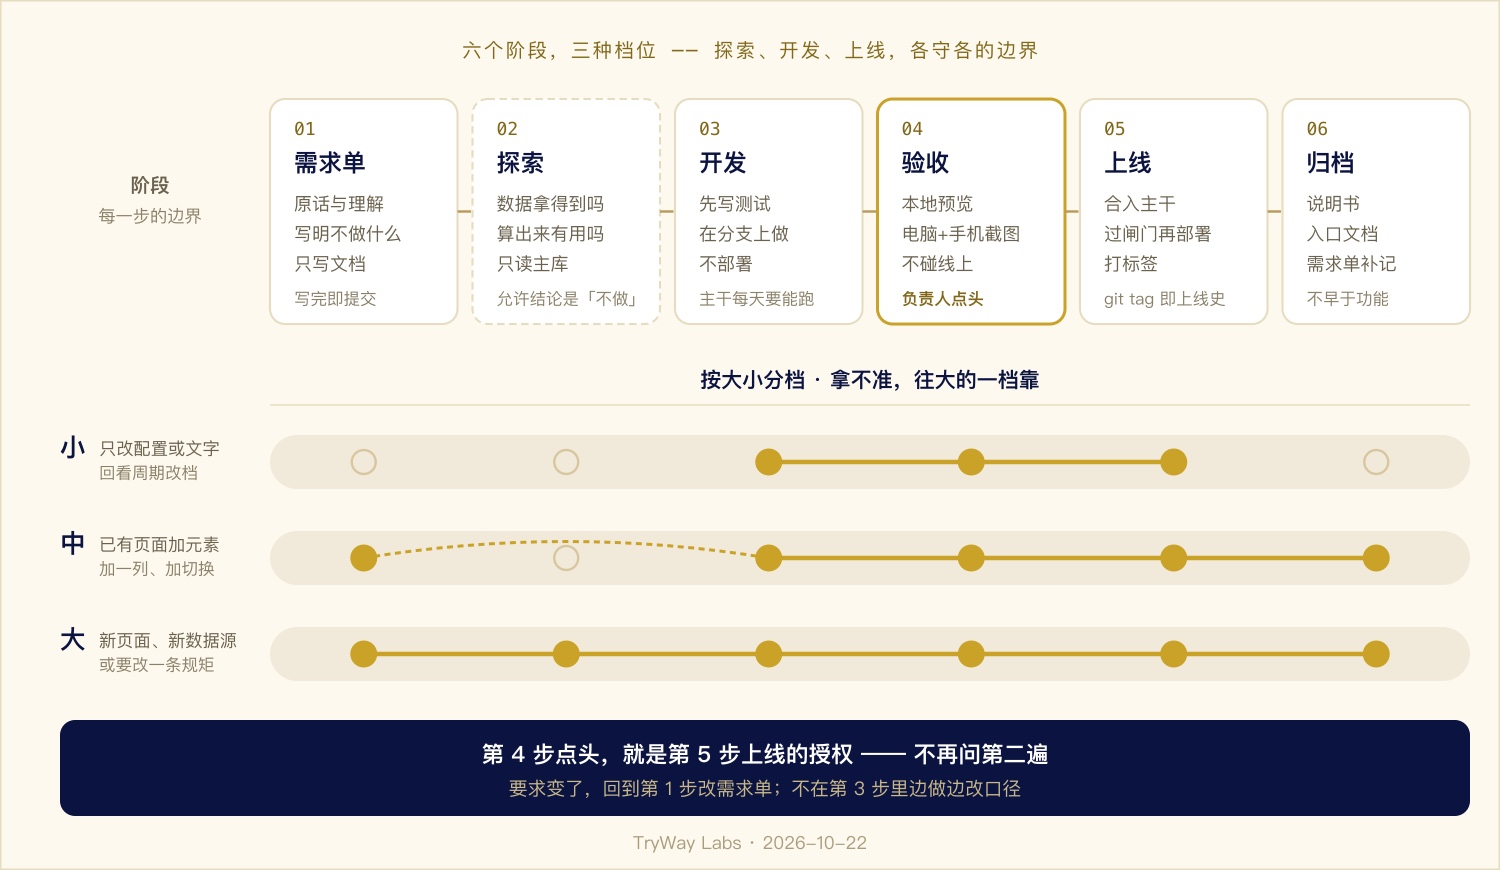
復盤當晚,規矩寫進了專案入口文件。核心是一張六階段表,每一步都寫明做什麼、邊界在哪、交出什麼:
| 階段 | 做什麼 | 邊界 | 產出 |
|---|---|---|---|
| 1 需求單 | 需求方原話、我們的理解、上線形式、不做什麼、待定項、驗收標準 | 只寫文件,不動程式和設定 | 一份帶日期的需求單,寫完即提交 |
| 2 探索(可選) | 資料拿不拿得到,算出來有沒有用 | 只讀主資料庫,腳本和資料另放,不發布;允許結論是「不做」 | 研究日誌 |
| 3 開發 | 先寫測試再實作 | 在分支上做,不部署;主幹必須每天 17 點能正常跑 | 程式碼與測試 |
| 4 驗收 | 本地產生站點,電腦和手機寬度各截圖 | 不碰線上,版式在這一步量好 | 負責人點頭 |
| 5 上線 | 合入主幹 → 部署 → 打標籤 | 有未提交的改動,程式拒絕部署 | 標籤 |
| 6 歸檔 | 更新說明書、入口文件,在需求單末尾記下實際做成了什麼 | 說明書不早於功能 | 文件提交 |
但不是每個小改動都要走全套六步,否則規矩就成了枷鎖。所以再按大小分三檔,拿不準就往大的一檔靠:
這張表裡有幾條看著不起眼,後來都證明是關鍵:
說明書不寫在前面。 系統的使用說明就是網站上的一頁,每天隨資料一起發布。先把新功能寫進說明書,需求方當晚就會讀到一個還不存在的功能。先寫的應該是需求單,說明書只能在驗收通過、合入主幹之後改,和功能同一次上線。
上線形式在需求單裡定。 這個站是純靜態頁,只有五類地方允許帶腳本:閱讀讀數、表格排序、說明書點圖放大、首頁按日期定位、個股 K 線圖。別處想加腳本、動畫,就算改規矩,按「大」檔處理,先出本地原型給負責人看。克制是一種設計:頁面越樸素,出錯的面越小。
點頭即授權。 負責人在第 4 步點頭,就是第 5 步合入和部署的授權,不用再問第二遍。規矩要防的是失控,不是要人反覆說 yes。
要求變了,回到第 1 步。 需求方的想法會反覆,會越挖越深,這再正常不過。可一旦在開發途中邊做邊改口徑,需求單就成了廢紙。改需求單只要幾分鐘,卻能讓後來的每一步都知道自己在對什麼標準幹活。
04 · 規矩要長出牙齒:把閘門寫進程式
寫在文件裡的規矩,靠的是自覺。人會忘,模型在長對話裡也會漂移,熬到凌晨兩點,誰都有「就這一次」的時候。所以最硬的幾條,直接寫進了程式。
閘門一:未提交不部署。 部署指令開頭先查 git:程式、設定、說明書這三處只要有未提交的改動(包括已暫存的、新增未追蹤的),就攔住,日誌列出是哪幾個檔案,網站不更新。為什麼只查這三處?因為它們決定線上長什麼樣;寫一行開發筆記、改一個測試,不該讓當天的網站停更。最要緊的一條是:有意不做繞過開關。留了後門的閘門,遲早會被走成大門。
閘門二:資料驟降即攔截。 每天會變的只有上游資料,所以發布前只設一道資料自檢:今天全市場的股票隻數,比前一個交易日少了超過 5%,就攔住發布,彈一條通知,等人核對。防的是資料來源當天還沒入全、只回傳一部分股票,程式卻把這天記成「已同步」,名單從此永久少一截,而且沒有任何提示。這個閾值不是拍腦袋:500 個交易日裡單日最大降幅只有 0.48%,日常波動碰不到 5%;而 2015 年 7 月千股停牌那幾天會被攔下,核對後人工放行,屬於預期之內。
兩道閘門之外,還有一條貫穿每日流程的鐵律:任何一步沒做成就停下,寧可今天不更新,也不發布半截結果。
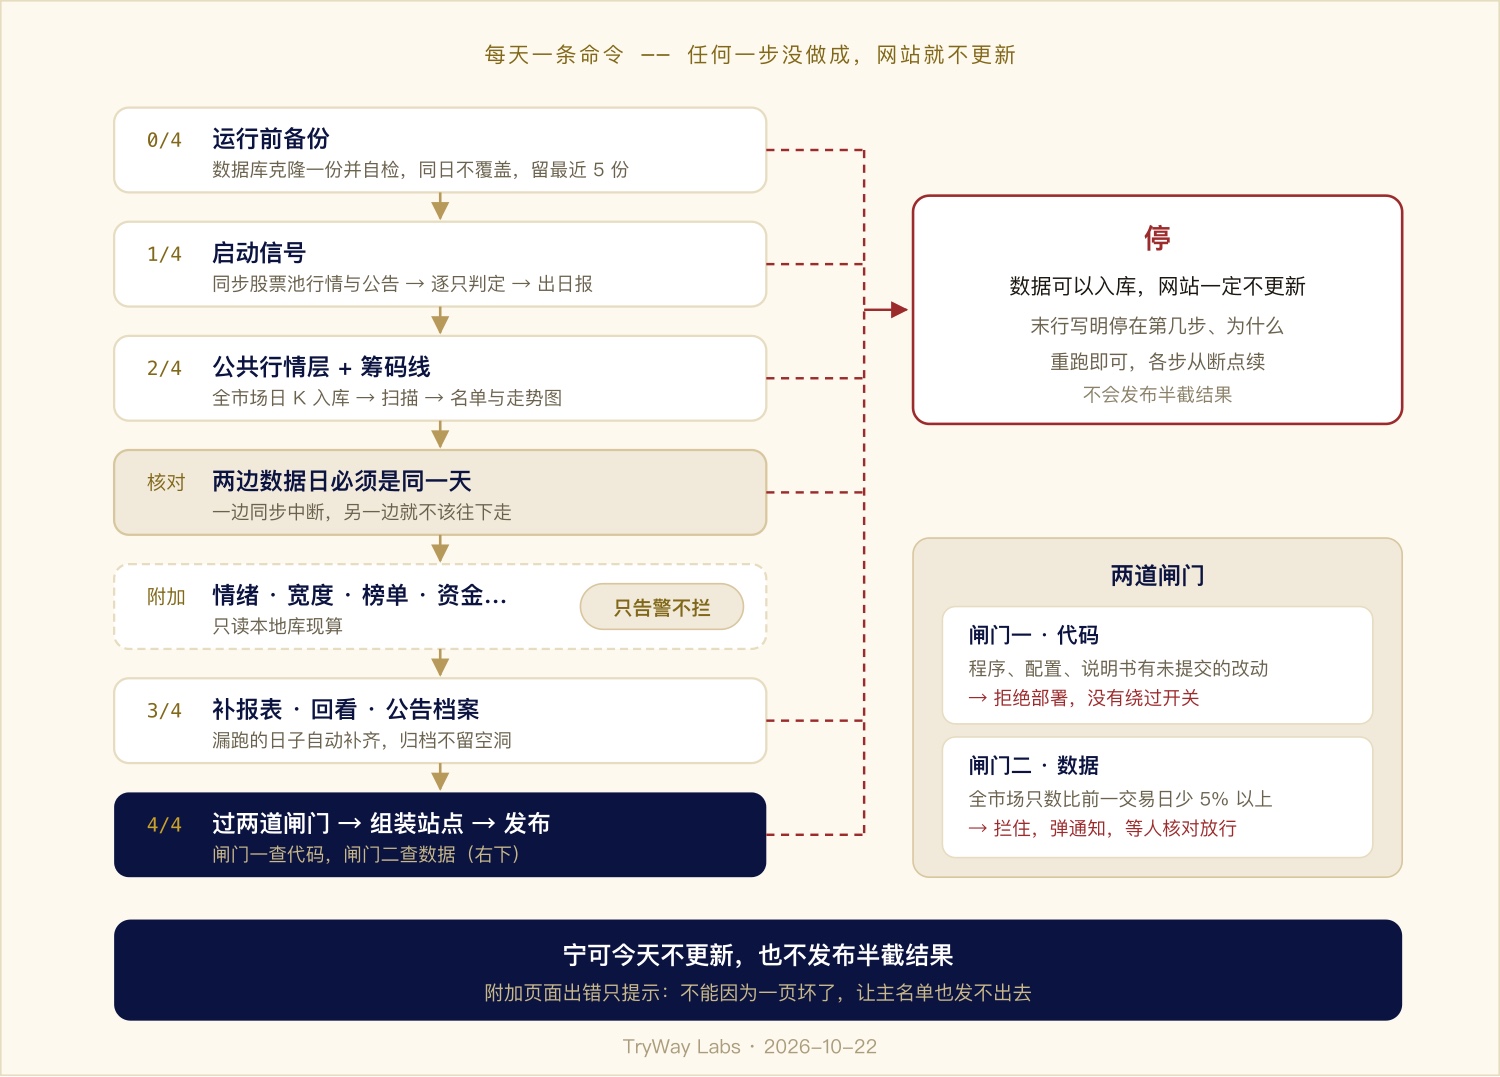
這裡有個分寸:情緒、寬度、榜單、資金這些附加頁面,出錯只告警,不攔主流程。不能因為一頁圖表壞了,就讓主名單也發不出去。該硬的地方要硬,該軟的地方要軟,這跟鐵路號誌一個道理:主幹道的紅燈必須停,側線上的故障,掛個牌子繞過去就行。
立規矩的那一晚,規矩本身也按新規矩上線了一次。先寫測試,再寫閘門;驗收時故意在工作區留了 3 個未提交的檔案,直接跑部署,結果被攔住,日誌列出 3 個檔案,結束碼 1,網站未更新。閘門第一次咬人,咬的是立規矩的人自己。這一口咬得好。
05 · 一口井,多根管:架構上的克制
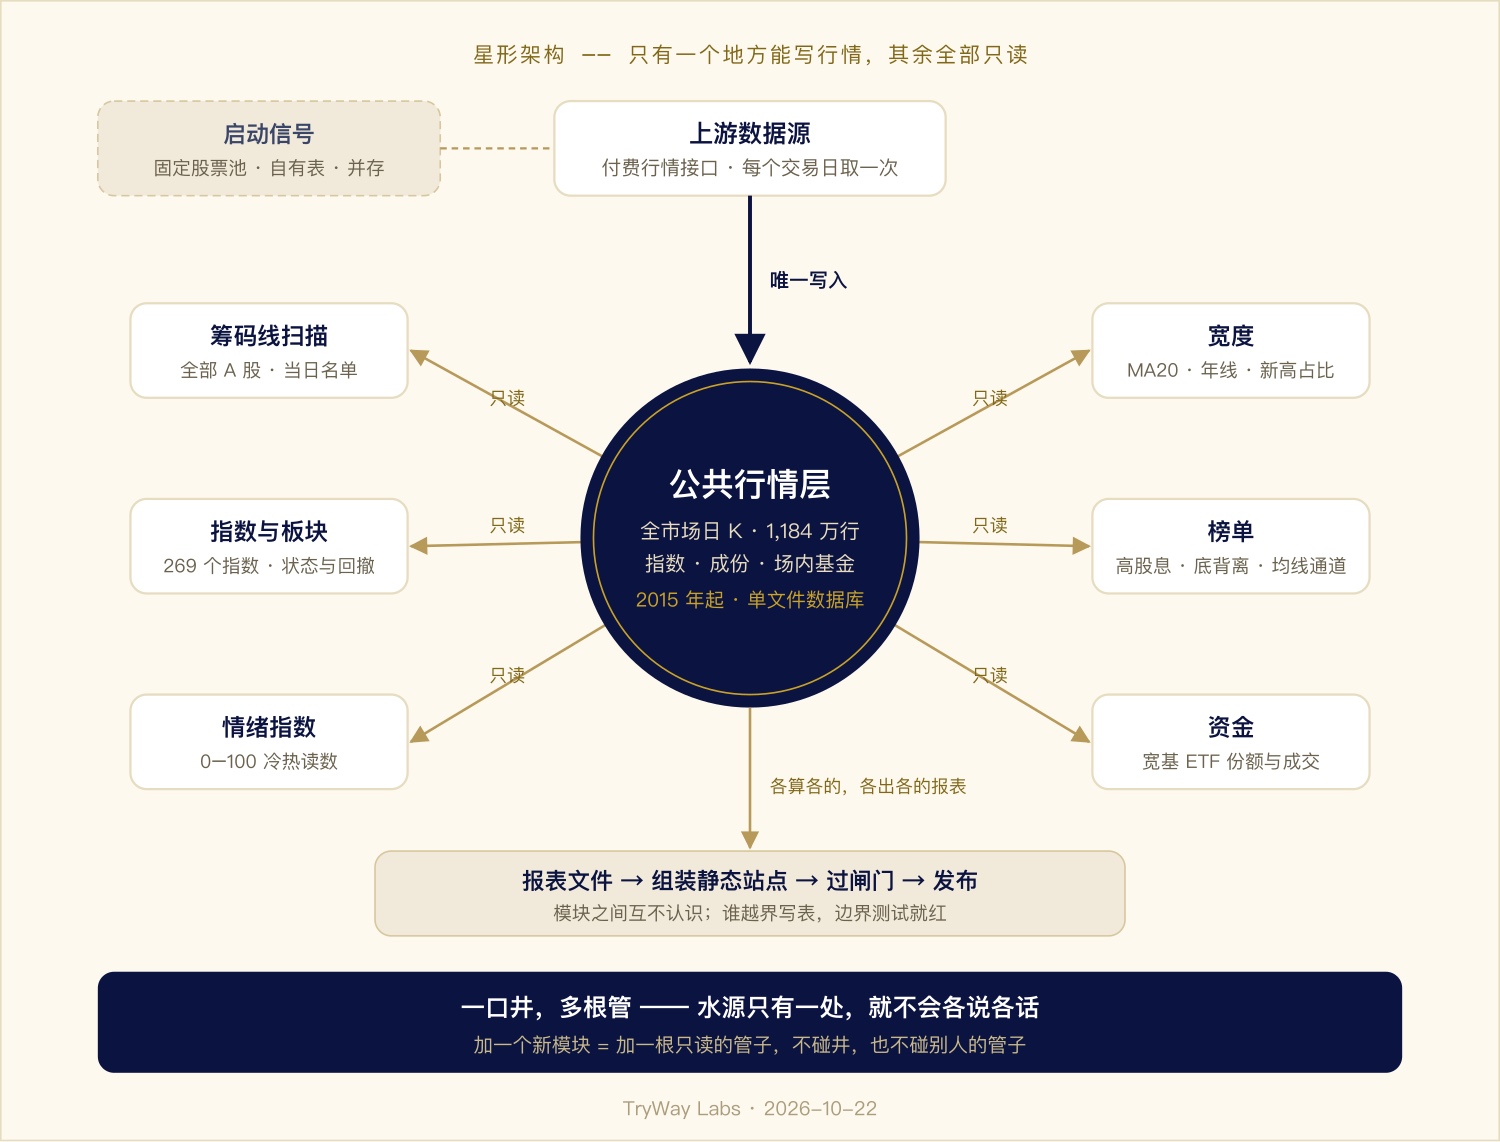
10 月 18 日那一輪最大的手術,是把全市場行情抽成一個公共行情層。
在此之前,籌碼線、指數板塊、情緒各自去資料來源取一份行情,各存各的。三張指數表裡,同一個指數同一天的收盤可能來自三次不同的請求。這就像一個村子每戶自己打井:水質對不對得上,全看運氣。
手術之後,整個系統變成了星形:
| 原則 | 做法 | 好處 |
|---|---|---|
| 唯一寫入口 | 只有公共層的兩個檔案能連網寫行情表 | 資料只有一個來源,各頁面不會各說各話 |
| 模組唯讀、互不認識 | 籌碼線、寬度、榜單、資金……都只讀公共層,各出各的報表 | 加一個新模組就是加一根唯讀的管子,不碰井,也不碰別人的管子 |
| 邊界用測試守 | 模組邊界測試自動檢查:誰越界寫了不該寫的表,測試就紅 | 架構約束不靠程式碼審查時的眼力 |
| 零第三方依賴 | 只用 Python 標準函式庫;單檔 SQLite;靜態 HTML + 內嵌 SVG | 沒有套件要升級,沒有供應鏈風險,裝好 Python 就能跑 |
最後一行值得多說一句。今天隨手 pip install 一個函式庫,幾乎沒有成本;可一個每天都要跑、要跑很多年的系統,每一個依賴都是一筆利息不明的長期貸款。唯一的例外是個股 K 線圖用的圖表函式庫:它隨站發布、不引外部位址,入庫時核對 npm 套件的 sha512,站點每次組裝時再核對一遍 sha256,不符即中止。依賴不是不能有,而是要有就得認得清、鎖得住。
公共層建好後,歷史也一口氣補到了 2015 年:約八千次介面呼叫,連續跑了一夜。中途網路斷開兩次,訂閱額度撞到五小時上限停過一次,終端機當機過一次。每一次都從日誌裡判斷進度,從斷點續上,沒有丟一行資料。長任務必須可續傳、自動重試、寫日誌,這條經驗是那一夜一刀一刀刻出來的。
06 · 證據壓倒自信:五道對拍
AI 寫程式碼最大的陷阱,不是寫錯,而是寫得像對的。測試全綠、頁面好看、數字合理,偏偏某個角落差了一點,而這一點肉眼看不出來。
所以這個專案的驗證,核心不是「測試通過」,而是對拍:拿一份獨立的答案,逐位比對。
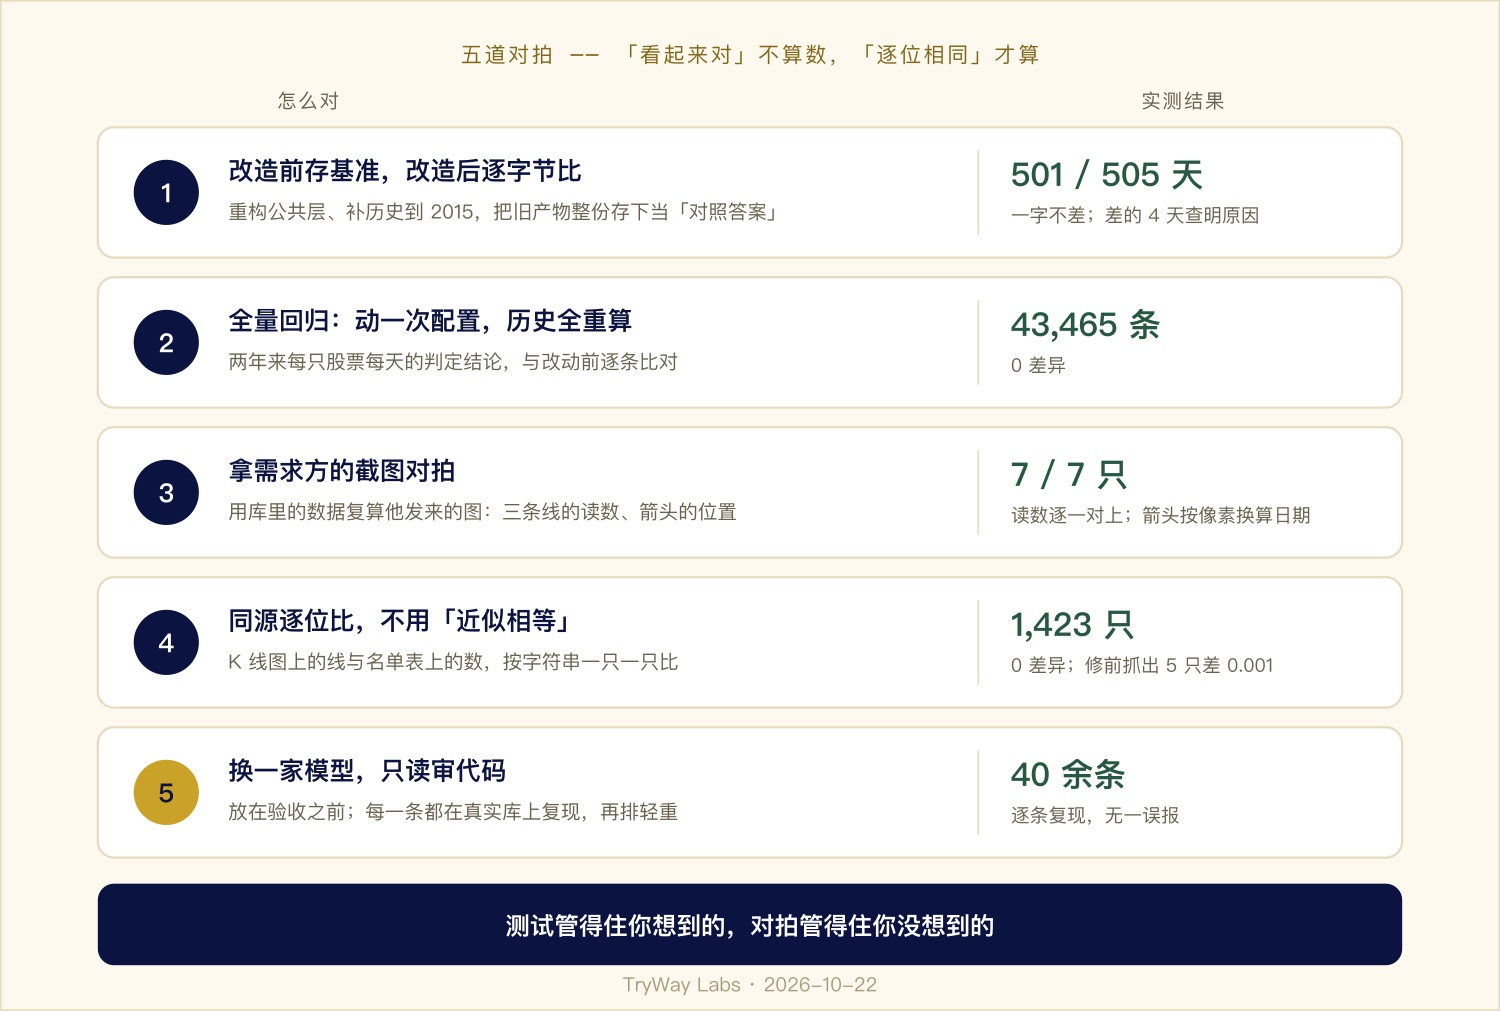
幾個故事,比數字更能說明問題。
基準逐位元組比。 重構公共層之前,先用舊程式碼把籌碼線的全部產物出一份,存作「對照答案」。重構、補歷史之後逐位元組比:505 天裡 501 天一字不差。差的 4 天,每天各多出 1 隻股票,查下去全是同一個原因:舊起點下,停牌股的 K 線只有 93 到 100 根,不夠公式要的 101 根;起點拉到 2015 年,夠數了。差異不可怕,可怕的是說不清差異從哪來。
拿需求方的截圖對拍。 均線通道那一輪,需求方深夜只發來一段通達信公式和 7 張截圖,沒有一個字的說明。沒有去猜他要什麼,而是先用資料庫裡的資料把 7 隻股票的三條線複算一遍,讀數逐一對上;再把截圖上紅箭頭的位置,和計算出的「最低價回踩下軌」的事件段逐隻對照,也對上了。意圖從猜測變成了證據。更關鍵的一步在後面:如果只看當天碰沒碰下軌,恰好會漏掉他舉的三個例子,因為它們前一天碰軌、當天已經大陽離開。「回看 5 日」這個口徑,就是這樣從需求方自己的例子裡推出來的。
同源逐位比。 個股 K 線圖上畫的三條線,和均線通道名單表上的數,用的是同一個演算法。照理說不該有差,可測試用的是「近似相等」,偏偏放過了 .xxx5 這種捨入邊界。改成 1,423 隻股票的字串逐一比,才抓出 5 隻差了 0.001。根子在浮點:一邊用前綴和,一邊直接求和,最後一位四捨五入的方向不同。改用精確求和之後,已上線的名單逐位元組不變,新圖與表 0 差異。
換一家模型來挑刺。 審查不讓寫程式碼的同一家模型自己審,而是請一家不同來源的模型,唯讀審查,放在驗收之前。幾輪下來累計提出 40 餘條問題,每一條都在真實資料庫上重現屬實,沒有一條誤報。其中最有分量的一條,是第一輪就抓到的:寬度模組的快取,會把重拉或換了成分之後的舊讀數發布出去。這類問題頁面上看不出來,驗收時根本發現不了。還有一條更直接:均線通道頁上寫的「停牌 32 隻」,當天就是錯的,應該是 3 隻。
審查方也會掉鏈子。K 線圖那一輪,第一家審查模型讀完程式碼,撞上用量上限,沒交清單。於是同一份委託書改派另一家,以唯讀模式審完,事後再查工作樹,確認它沒有改動一個檔案。審查方要有備份,這條也是撞出來的。
測試管得住你想到的,對拍管得住你沒想到的。兩者缺一不可。
07 · 不替人拍板,也不反覆追問:口徑台帳
需求方給的是一張經驗表,經驗表天然有空白。「大陽線配溫和檔的量能,算什麼?」「市值分檔用總市值還是流通市值?」「寬度的分母含不含停牌股?」這些問題,需求方沒說,程式又不能不跑。
兩種常見的處理都不對:替需求方拍板,等於把自己的理解偷偷塞進他的系統;每遇到一個就去追問,人家只是想看個名單,不是來陪你開需求會的。
這個專案的做法是第三條路:每個說不清的口徑,都做成設定項、給一個預設值,記進台帳。
| 台帳欄位 | 例子 |
|---|---|
| 編號與模組 | K7 · 高股息 |
| 坑是什麼 | 股息率用近 12 月還是靜態的排 |
| 現在的預設 | 近 12 月 |
| 誰定的 | 需求方 |
| 改了要重跑什麼 | 只改設定,重出高股息頁 |
10 月 18 日那一輪,台帳記了 34 項:需求方定 13 項,負責人定 13 項,其餘自查。當天下午需求方一口氣回覆了 12 條口徑,兩小時內全部落地,幾乎只改了設定。啟動訊號那個最大的懸案,大陽線配溫和量能算什麼,至今沒定,程式就老老實實標成「待定」,單列出來供人判斷,絕不擅自歸檔。
台帳的價值不在於記得全,而在於誰定的、預設是什麼、改了重跑什麼,一眼就能看清。它把「需求沒說清」從一種焦慮,變成了一張可以慢慢清的帳。
08 · 人機分工:agent 幹活,人按按鈕
這套方法裡,人和 AI 的分工是這樣的:
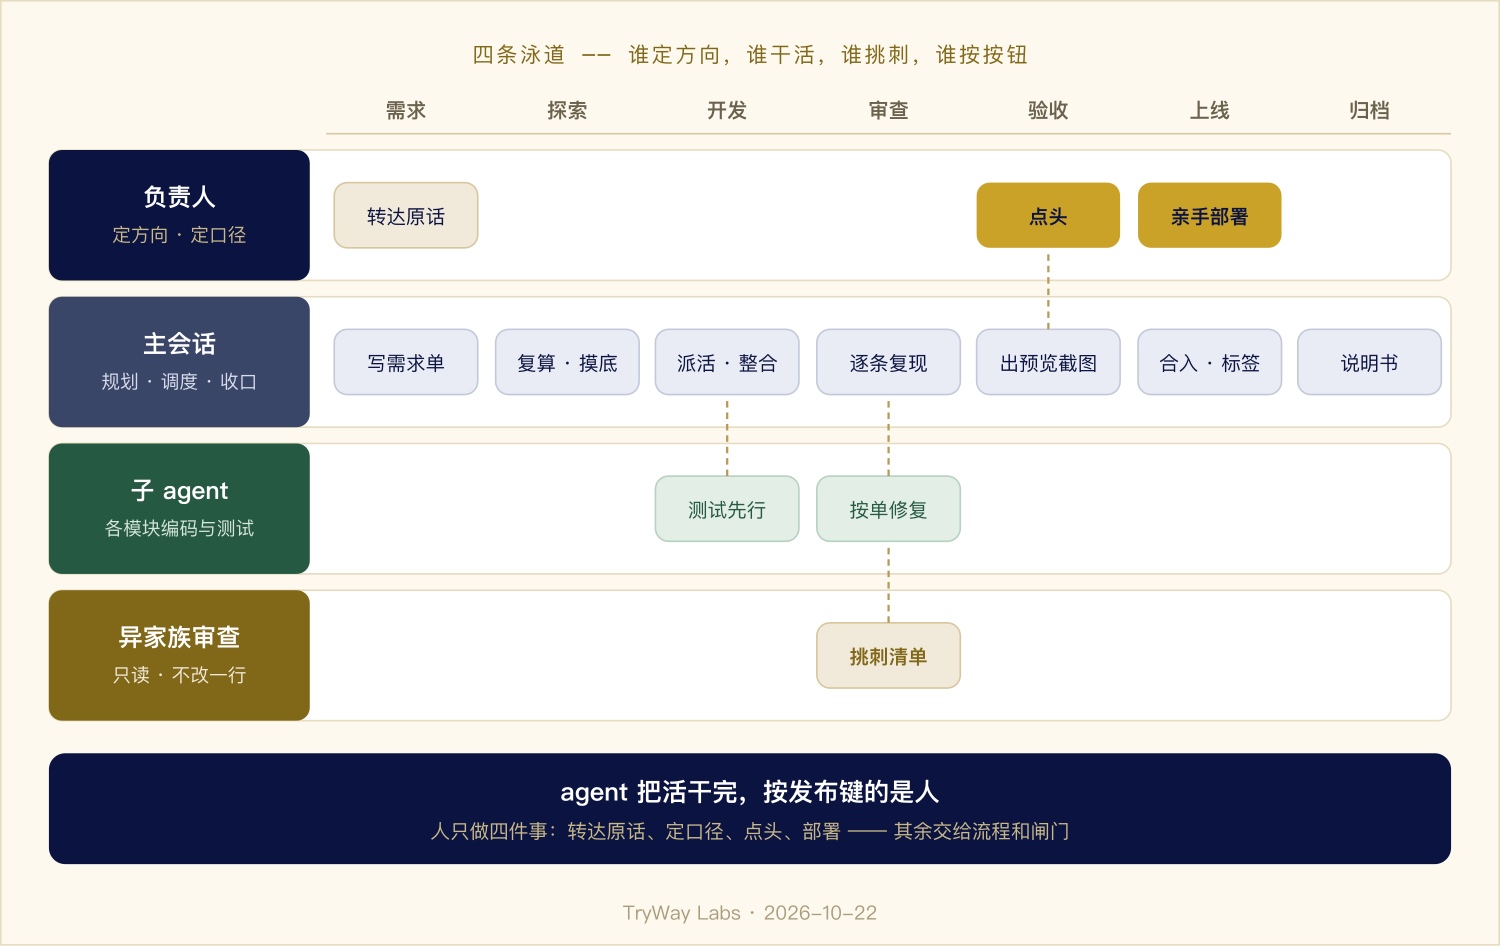
其中最有意思的一條是部署由人親手執行。合入主幹、產生站點、核對產物,這些 agent 都做好了,最後那條部署指令,交給負責人在終端機裡自己敲。這不是對 AI 的不信任,而是讓「上線」這個不可逆的動作,始終有一個人類的手指按在上面。半自動,不是因為做不到全自動,而是有意留三分摩擦。
這一套跑下來,帳是這樣算的:
| 項 | 數字(五輪累計) |
|---|---|
| 模型分工 | 主會話 Claude Opus 5.5 · 子 agent Claude Sonnet 5.5 · 唯讀審查 Codex 與 grok |
| 時長 | 約 85 小時(10-17 23:14 → 10-21 11:55) |
| 提交與上線 | 217 個提交,14 次上線,每次打標籤 |
| 模型呼叫 | 主會話與子 agent 共 2,325 次 |
| token 總量 | 約 6.21 億,九成以上是快取讀取 |
| 按 API 標價折算 | 約 187 到 209 美元 |
| 實際付費 | 訂閱制,不按 token 另計 |
其中兩點值得單獨說。
快取才是大頭。 九成以上的 token 是快取讀取,如果不用快取、全部按基礎輸入價計,同樣的工作量大約要貴十倍。長專案裡,讓上下文穩定、可快取,本身就是省錢的工程。
效率提升幾成,不知道。 開發過程中做過一次換算:同樣的 token 量,按半年前的模型單價算,Claude 這一側約貴一倍。但這只是單價差,不是效率差。舊模型可能要多走幾輪、多返工,開發工具本身也在變,規矩本身又省掉了大量返工,混在一起拆不開。要可信的數,只能拿同一份需求單讓新舊模型各做一遍。沒做之前,任何「提升幾倍」的說法都是猜。
09 · 摔過的跟頭,都要記下來
方法論不是一路順風寫出來的。這三週裡摔過的跟頭,每一個都換來了一條規矩或一個習慣:
| 跟頭 | 換來的規矩 |
|---|---|
| 夜裡補歷史,網路斷兩次 | 長任務可續傳、自動重試、寫日誌 |
| 訂閱額度撞到五小時上限,agent 中途被截斷 | 提交勤落盤,斷了也能從最近一個提交接上 |
| 終端機當機,主會話斷開 | 進度寫在日誌和看板裡,新會話讀日誌續跑 |
| 開發看板的全表計數鎖住了正在寫入的資料庫,補歷史失敗 | 寫資料庫時別平行讀資料庫 |
| 一天裡有 11 個提交誤帶了不該有的署名行 | 提交前看一眼作者和署名;合併提交尤其要看 |
| 審查第一次開成了可寫權限 | 審查一律唯讀,結論必須完整寫在對話裡 |
| K 線圖資料量調研估 28 MB,正式版 50.6 MB | 估計在實測後如實更正,並給出可選的最佳化 |
| 預設排序把天天砸穿下軌的票排在最前 | 本地預覽要真點、真排,測試覆蓋不到人的眼睛 |
最後一條值得多說一句。均線通道上線前,所有測試都綠著,可在瀏覽器裡一點,預設排序把一路暴跌、遠在下軌之下的票排在了最前面;日期欄點了不排,因為解析函式只認出了年份。這些問題測試不會發現,因為測試只檢查程式有沒有照設計做,不檢查設計本身合不合人意。驗收這一步必須有人,有眼睛,有手。
還有一條,是整個過程中最打動人的:承認不知道。成本報告裡寫「效率提升幾成不知道」,台帳裡寫「這一項需求方沒說,我們先按預設做」,稽核報告裡給每個推算的數字標上「推算」。一個系統最可貴的品質,不是永遠正確,而是你永遠知道它在哪裡可能不對。
10 · 舉一反三:四根柱子,一副地基
把這三週的經驗收攏,是這樣一座屋子:
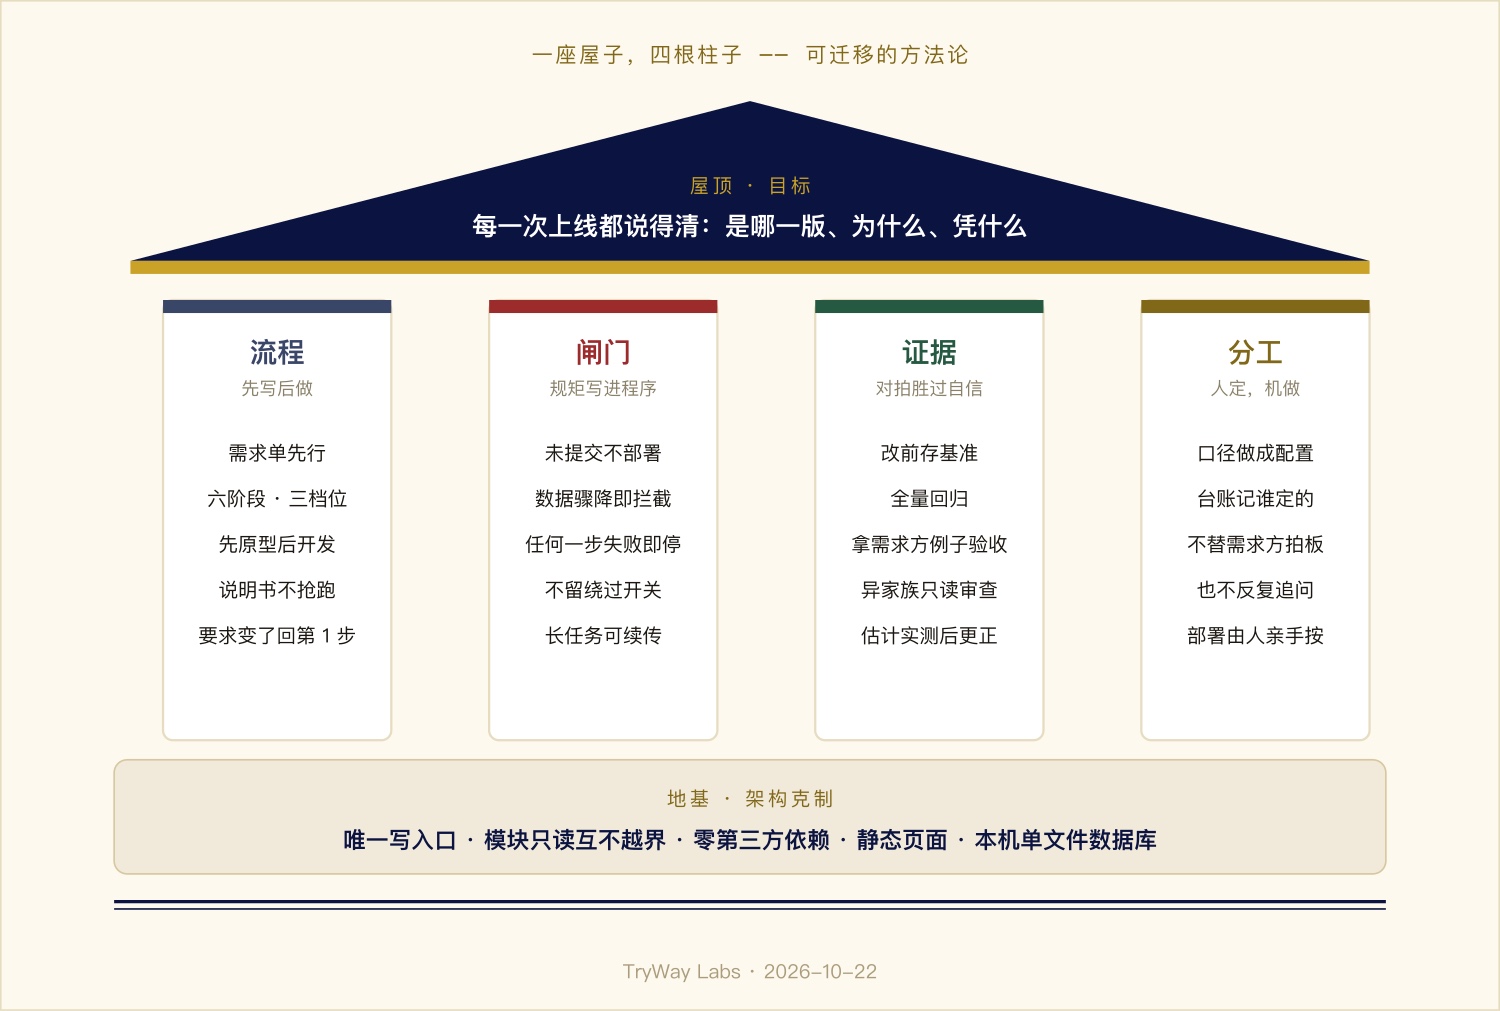
| 柱子 | 一句話 | 遷移到你的專案,先做這一件 |
|---|---|---|
| 流程 | 先寫後做 | 下一個需求開工前,寫一頁紙:原話、理解、不做什麼、驗收標準 |
| 閘門 | 規矩寫進程式 | 在部署腳本開頭加一行:工作區不乾淨就結束 |
| 證據 | 對拍勝過自信 | 下一次重構前,把現有產物整份存下,改完逐位元組比 |
| 分工 | 人定,機做 | 列一張口徑台帳;把部署那一步留給人 |
| 地基 | 架構克制 | 資料只留一個寫入口;每加一個依賴,先問能不能不加 |
這五件事,單拎出來沒有一件新鮮。需求單、發布閘門、特徵測試、設定化,軟體工程教科書裡早就寫過。新鮮的是語境:當寫程式碼的成本被 AI 壓到接近於零,這些老規矩的價值不降反升。從前寫程式碼慢,慢本身就是一種閘門,人在敲鍵盤的間隙裡自然會想一想;現在程式碼幾分鐘就出來,這道天然的閘門沒了,只能靠人造的閘門補上。
工欲善其事,必先利其器。可器已經利到這個程度了,下一步要修的,是用器的規矩。
11 · 尾聲:規矩是給自由修的路
回頭看那張最初的閾值表,它現在還在系統的最深處,六個條件,三檔市值,一個字沒改。系統長大了十倍,可需求方最初的那份經驗,被原封不動地供在那裡,所有沒說清的地方都記在台帳上,等他來定。
這或許就是規矩的意義。它不是捆住手腳的繩子,而是讓人敢跑快的路。有了閘門,才敢讓 agent 放手去寫;有了對拍,才敢在一夜之間重構整個資料底座;有了台帳,才敢對需求方說:你沒想好的,我們先替你記著,不替你決定。
從前寫程式碼慢,規矩是一種奢侈。如今程式碼寫得飛快,規矩成了剛需。也許下一個階段,連規矩本身也會由 AI 來提議、由人來拍板。那就是另一篇文章了。
文中系統只做篩選與記錄,不做收益回測,不構成任何投資建議。文中數字截至 2026-10-21,取自專案內部稽核記錄。